AI Servers
Serveur IA 4 GPU
Jusqu'à 4 GPU NVIDIA dans un châssis compact 2U — densité GPU maximale par unité de rack pour l'entraînement IA de moyenne échelle et l'inférence simultanée.
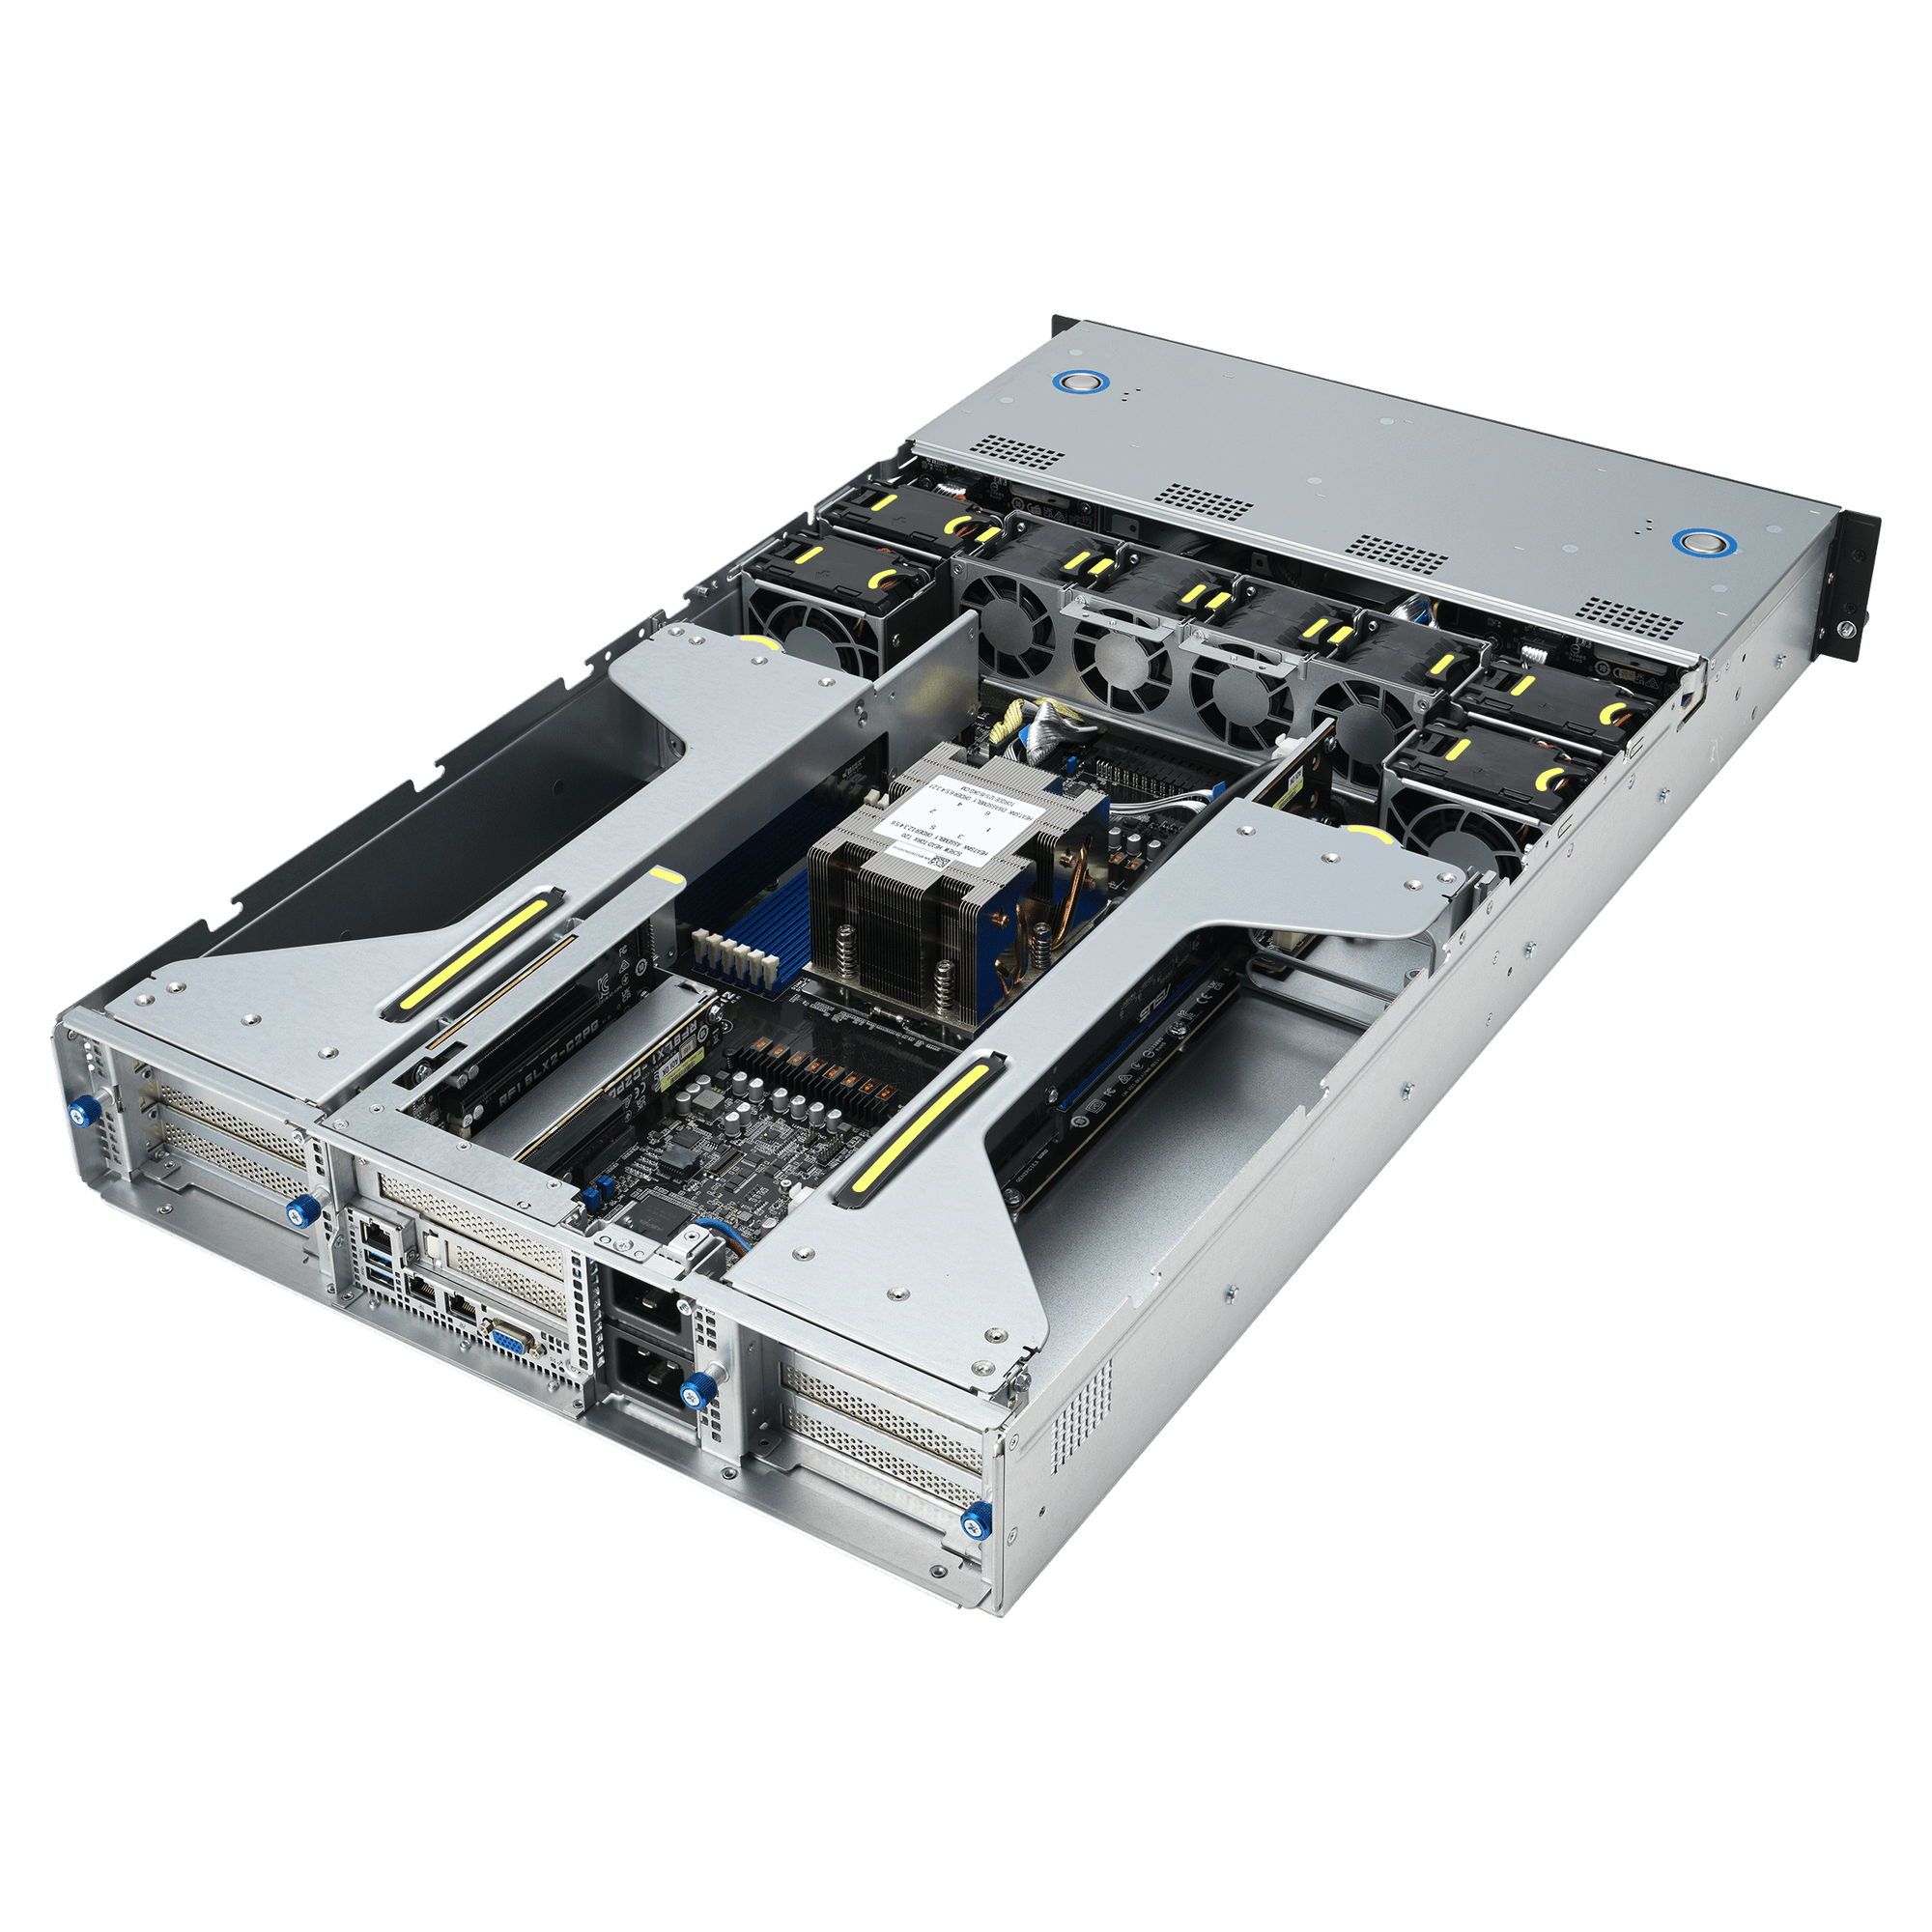
Caractéristiques principales
Charges de travail idéales
Mid-Scale Training
Train models efficiently with up to 4x NVIDIA H100 NVL GPUs.
Concurrent Inference
Run multiple isolated inference workloads on one node.
Spécifications techniques
| Chassis | 2U Rackmount |
|---|---|
| GPU Support | L4, L40S, H100 NVL — 2 to 4 GPUs |
| Memory | Up to 1.5 TB DDR5 |
Accélérez les charges de travail exigeantes d'intelligence artificielle et d'apprentissage automatique avec un serveur IA à 4 GPU conçu pour l'entraînement de LLM haute performance, l'inférence, le fine-tuning, l'IA générative et le calcul accéléré par GPU. En réunissant quatre GPU haute performance dans un seul serveur, il offre un équilibre puissant entre densité de calcul, évolutivité et efficacité de l'infrastructure pour les entreprises, les développeurs IA, les organismes de recherche et les centres de données.
Un serveur IA à 4 GPU constitue la solution idéale pour les charges de travail nécessitant nettement plus de puissance de calcul et de mémoire GPU qu'un système mono- ou bi-GPU, tout en restant plus compact et plus économique que des clusters GPU multinœuds de plus grande envergure. Cette configuration convient aussi bien aux environnements de développement IA qu'aux environnements de production.
Conçu pour l'IA d'entreprise et l'apprentissage automatique
Avec quatre GPU travaillant de concert, ces systèmes accélèrent un large éventail d'applications gourmandes en calcul, notamment :
Entraînement de grands modèles de langage (LLM)
Inférence LLM et mise à disposition de modèles
Applications d'IA générative
Fine-tuning de modèles IA
Développement de modèles de fondation
Génération augmentée par récupération (RAG)
Agents IA et charges de travail de raisonnement
Vision par ordinateur
Traitement du langage naturel
IA multimodale
Analytique accélérée par GPU
Calcul scientifique et HPC
Recherche et expérimentation en IA
Architecture multi-GPU à haute densité
Un serveur à 4 GPU offre un environnement multi-GPU étroitement intégré pour les applications capables de répartir les charges de travail entre plusieurs accélérateurs. Selon le GPU et la plateforme serveur retenus, les technologies d'interconnexion GPU à haut débit peuvent améliorer la communication entre les GPU et accélérer les charges de travail nécessitant des échanges de données fréquents.
Cela rend les systèmes à quatre GPU particulièrement attractifs pour l'entraînement IA, l'inférence distribuée, la simulation et d'autres charges parallèles où des ressources GPU supplémentaires réduisent sensiblement les temps de traitement.
Une infrastructure IA flexible
Les serveurs IA à 4 GPU peuvent être configurés avec différentes classes d'accélérateurs NVIDIA ou autres, selon les exigences des charges de travail, les besoins en mémoire GPU, les contraintes d'alimentation et les objectifs de performance. Cette flexibilité permet aux organisations de bâtir leur infrastructure autour d'applications IA précises plutôt que d'adopter une configuration standardisée.
Ils conviennent aux centres de données d'entreprise, aux startups IA, aux laboratoires de recherche, aux universités, aux clouds IA privés et aux environnements de calcul GPU.
Points clés
Configuration serveur IA à 4 GPU
Architecture multi-GPU haute performance
Conçu pour l'entraînement et l'inférence de LLM
Idéal pour l'IA générative et les modèles de fondation
Prend en charge le fine-tuning, le RAG, les agents IA et les charges multimodales
Forte densité de calcul GPU dans un seul serveur
Adapté au développement IA, à la recherche et à la production
Configurations GPU et serveur flexibles
Base efficace pour une infrastructure IA évolutive
Tremplin idéal vers des clusters GPU de plus grande taille
Que vous développiez de grands modèles de langage, déployiez des applications d'IA générative, affiniez des modèles de fondation ou exécutiez des charges de recherche intensives en GPU, un serveur IA à 4 GPU apporte la densité de calcul et l'évolutivité nécessaires pour accélérer votre infrastructure IA moderne.
Questions fréquentes
Proposez-vous des serveurs GPU pour l'entraînement et l'inférence de modèles d'IA ?
Quels délais de livraison prévoir pour les serveurs GPU ?
Proposez-vous des solutions de financement pour l'infrastructure GPU ?
Comment demander une consultation ou un devis ?
Prêt à démarrer ?
Construisez votre infrastructure IA en toute confiance
Échangez avec notre équipe d'infrastructure d'entreprise. Bénéficiez de conseils d'experts, de tarifs GPU et d'un plan de déploiement sur mesure — sans engagement.