AI Servers
4 GPU AI 服务器
在紧凑的 2U 机箱内最多支持 4 颗 NVIDIA GPU——最大化每机架单元的 GPU 密度,适用于中等规模 AI 训练与并发推理。
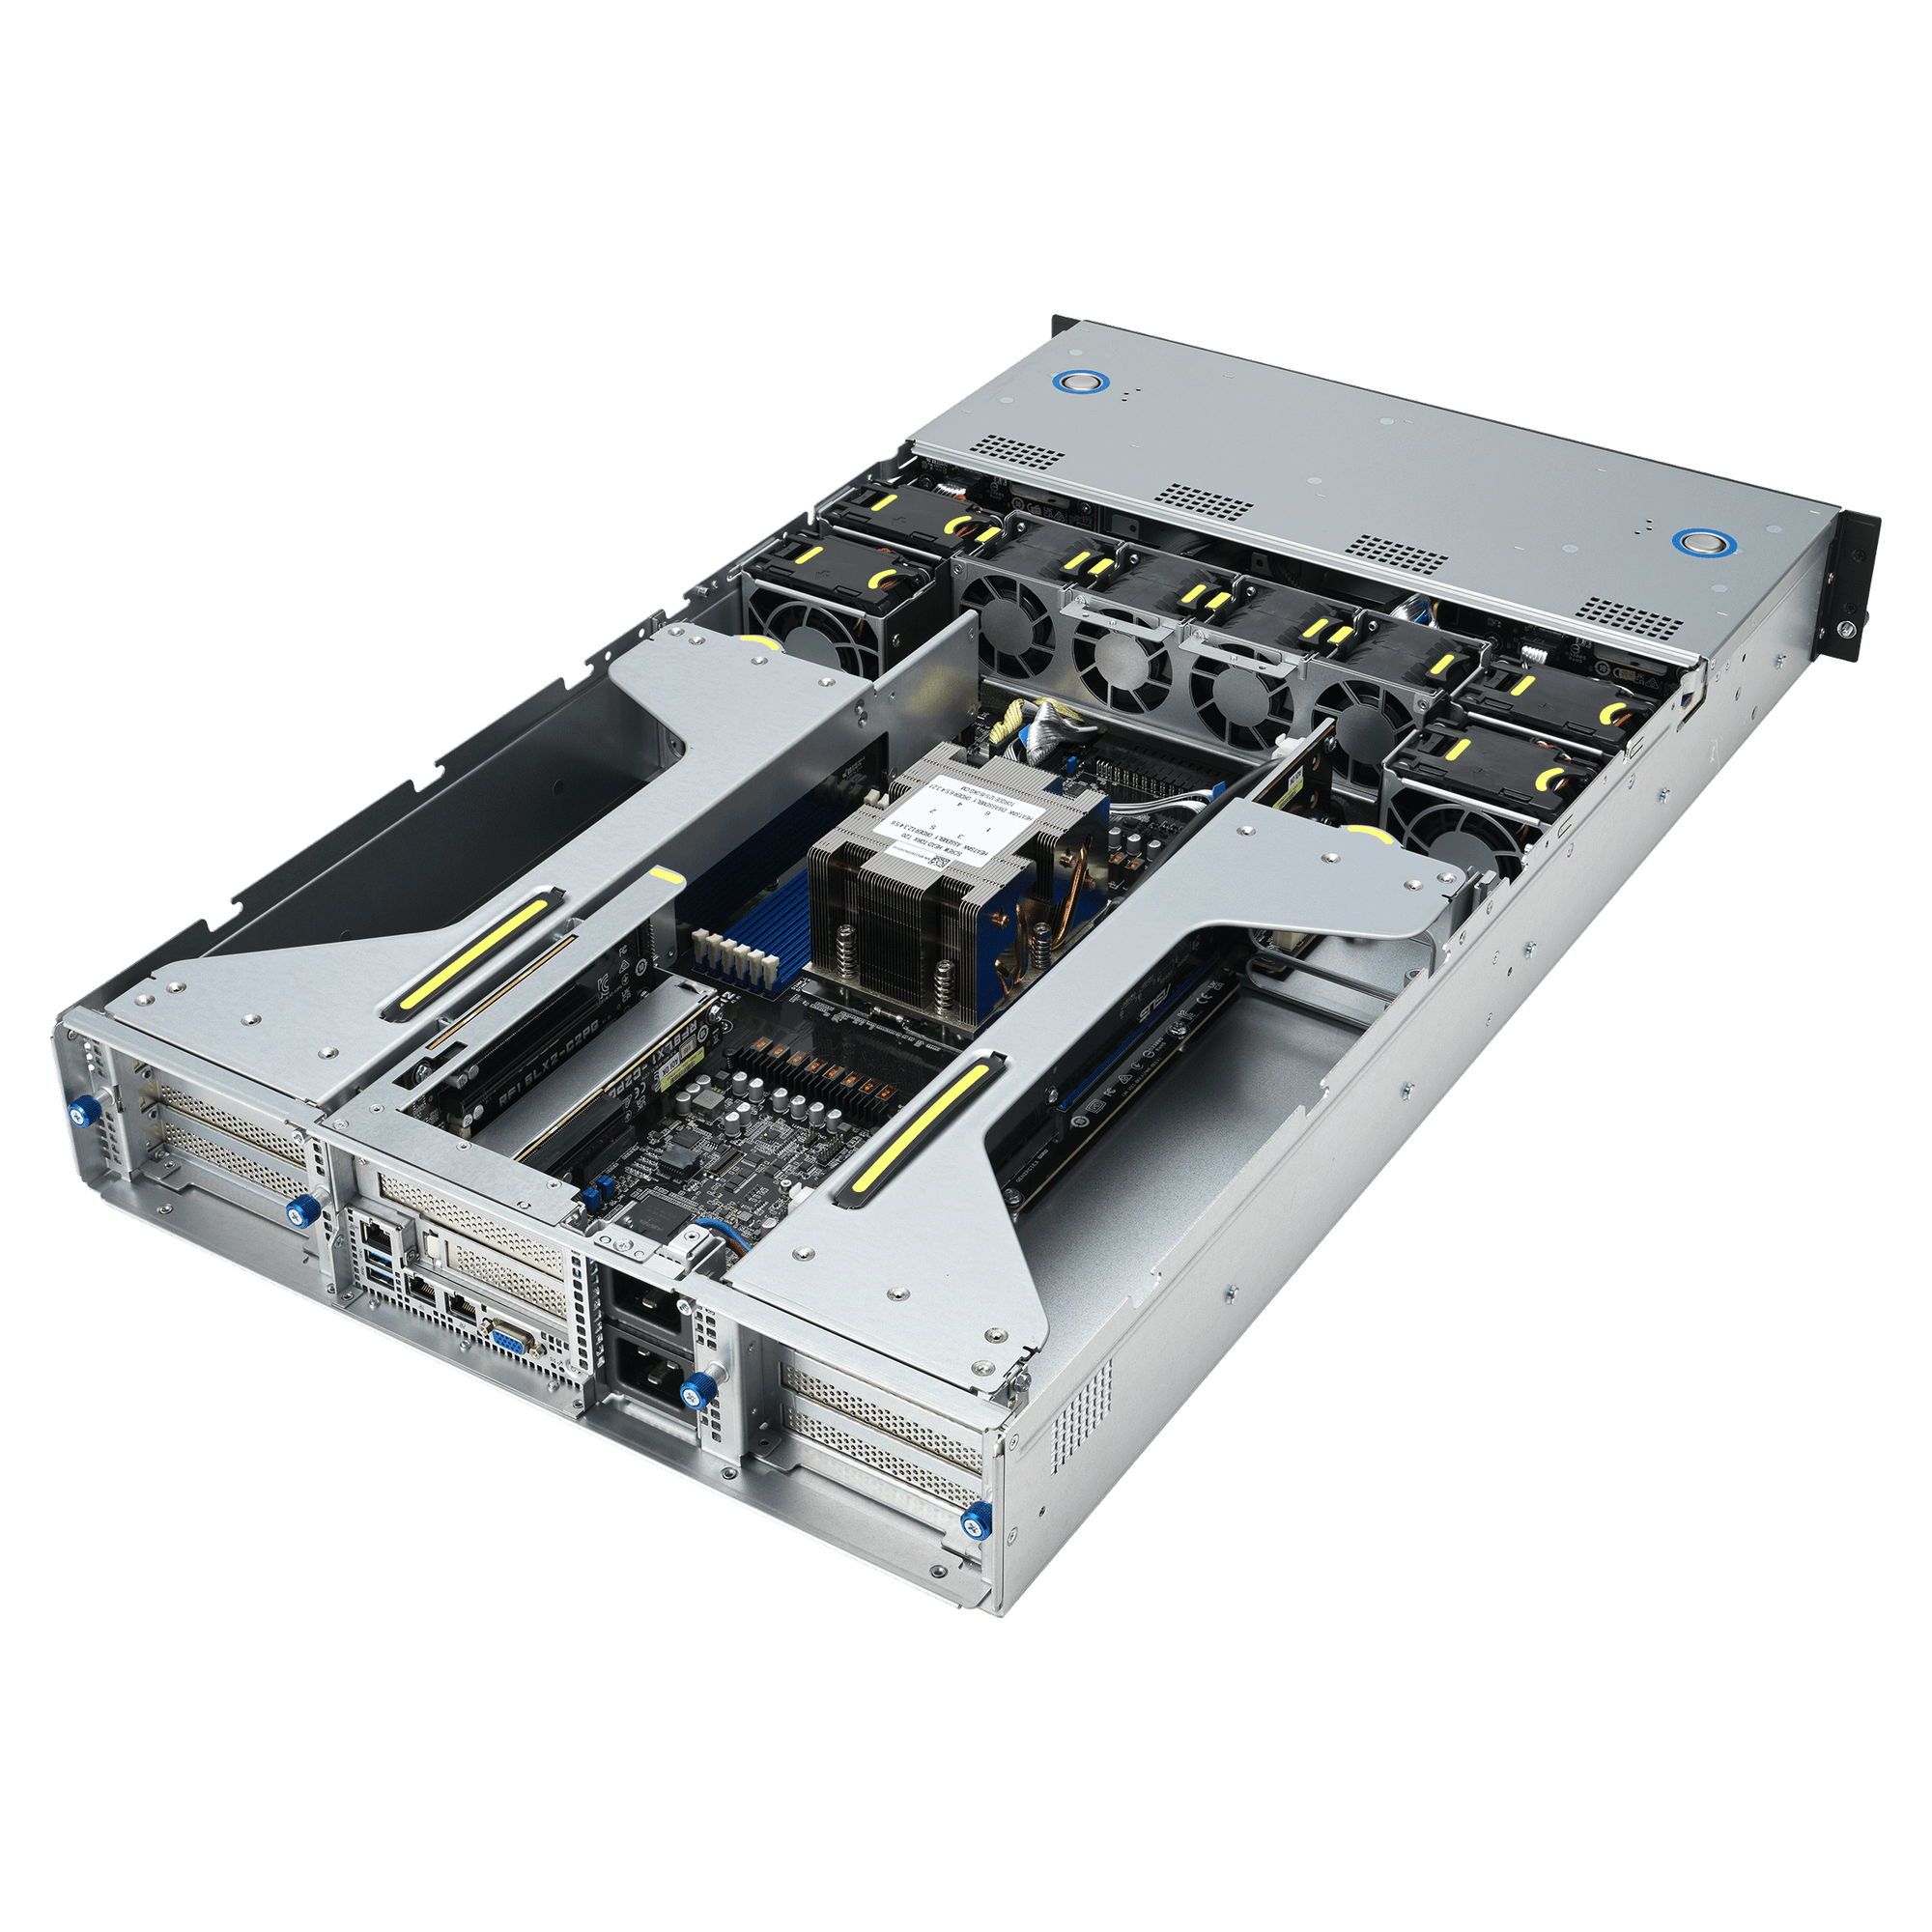
主要规格
适用场景
Mid-Scale Training
Train models efficiently with up to 4x NVIDIA H100 NVL GPUs.
Concurrent Inference
Run multiple isolated inference workloads on one node.
技术规格
| Chassis | 2U Rackmount |
|---|---|
| GPU Support | L4, L40S, H100 NVL — 2 to 4 GPUs |
| Memory | Up to 1.5 TB DDR5 |
借助专为高性能 LLM 训练、推理、微调、生成式 AI 和 GPU 加速计算而设计的 4 GPU AI 服务器,加速要求严苛的人工智能与机器学习工作负载。将四块高性能 GPU 集成于单台服务器,为企业、AI 开发者、科研机构和数据中心提供计算密度、可扩展性与基础设施效率之间的强大平衡。
对于所需 GPU 算力和显存远超单卡或双卡系统的工作负载而言,4 GPU AI 服务器是理想选择,同时又比大型多节点 GPU 集群更为紧凑且更具成本效益。该配置同样适用于 AI 开发环境与生产环境。
专为企业 AI 与机器学习打造
四块 GPU 协同工作,这类系统可加速各类计算密集型应用,包括:
大语言模型(LLM)训练
LLM 推理与模型服务
生成式 AI 应用
AI 模型微调
基础模型开发
检索增强生成(RAG)
AI 智能体与推理类工作负载
计算机视觉
自然语言处理
多模态 AI
GPU 加速分析
科学计算与 HPC
AI 研究与实验
高密度多 GPU 架构
4 GPU 服务器为可在多个加速器之间分配工作负载的应用提供紧密集成的多 GPU 环境。根据所选 GPU 与服务器平台的不同,高速 GPU 互连技术有助于改善 GPU 之间的通信,并加速需要频繁数据交换的工作负载。
这使得四 GPU 系统在 AI 训练、分布式推理、仿真以及其他并行工作负载中格外具有吸引力——在这些场景中,额外的 GPU 资源可显著缩短处理时间。
灵活的 AI 基础设施
4 GPU AI 服务器可根据工作负载需求、显存需求、功耗限制和性能目标,配置不同级别的 NVIDIA 或其他加速器硬件。这种灵活性使企业能够围绕特定 AI 应用构建基础设施,而无需采用千篇一律的配置。
它们适用于企业数据中心、AI 初创公司、研究实验室、高校、私有 AI 云以及 GPU 计算环境。
核心亮点
4 GPU AI 服务器配置
高性能多 GPU 架构
专为 LLM 训练与推理设计
适用于生成式 AI 与基础模型
支持微调、RAG、AI 智能体与多模态工作负载
单台服务器内的高 GPU 计算密度
适合 AI 开发、研究与生产
灵活的 GPU 与服务器配置
可扩展 AI 基础设施的高效基石
迈向更大规模 GPU 集群的理想跳板
无论您是在开发大语言模型、部署生成式 AI 应用、微调基础模型,还是运行 GPU 密集型科研工作负载,4 GPU AI 服务器都能提供加速现代 AI 基础设施所需的计算密度与可扩展性。
常见问题
你们提供用于 AI 模型训练和推理的 GPU 服务器吗?
GPU 服务器的交付周期大约是多久?
你们为 GPU 基础设施提供融资方案吗?
我如何申请咨询或报价?
准备好开始了吗?
构建您的 AI 基础设施 信心十足
与我们的企业基础设施团队交流。获取专家指导、GPU 报价以及定制部署方案——无需任何承诺。