NVIDIA DGX
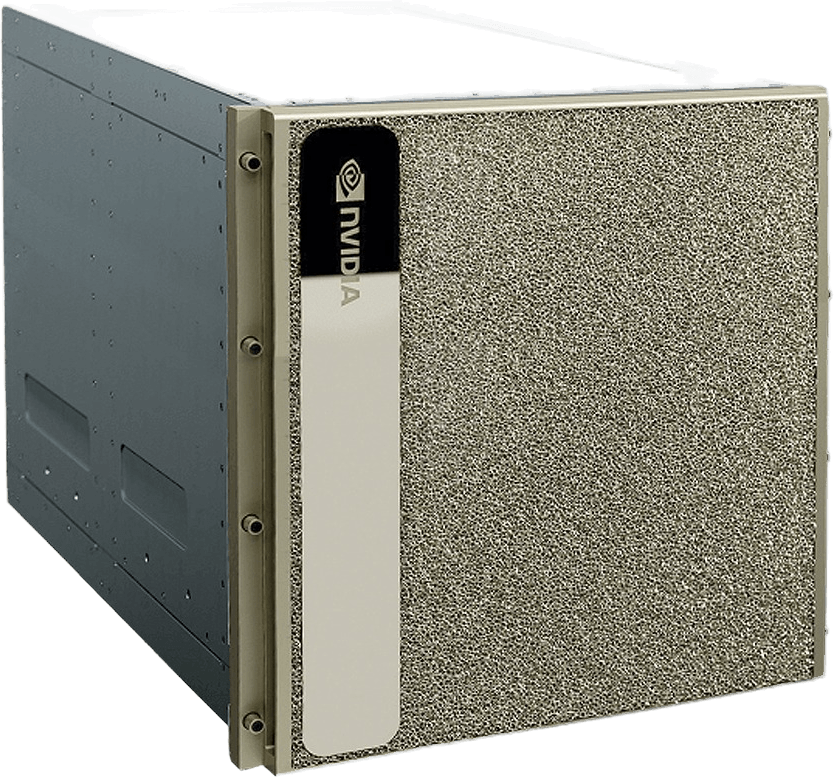
NVIDIA DGX B200
面向从开发到部署全流程的统一 AI 平台,配备 8 颗 Blackwell GPU 与 1.4 TB HBM3e——训练性能最高提升至上一代的 3 倍,推理性能最高达 15 倍。
主要规格
适用场景
Foundation Model Training
Full-stack platform validated for large-scale distributed training.
Multi-Modal Workloads
Vision, language, and speech pipelines on one platform.
技术规格
| Chassis | NVIDIA DGX B200, 10U |
|---|---|
| CPU | 2x Intel Xeon Platinum 8570 |
| GPU | 8x NVIDIA B200 SXM, 1.4 TB HBM3e |
| System Memory | Up to 4 TB DDR5 |
| Networking | 8x OSFP 400 Gb InfiniBand |
借助 NVIDIA DGX B200 加速企业级人工智能。该高性能 AI 系统基于 NVIDIA Blackwell 架构构建,专为高要求的 LLM 训练、推理、微调、生成式 AI 及高性能计算工作负载而设计。
NVIDIA DGX B200 将多颗 Blackwell GPU、高带宽 GPU 显存、先进的 NVLink 互连以及专门打造的系统架构整合为一体化 AI 平台。它旨在提供训练、微调和部署日益庞大且复杂的 AI 模型所需的计算性能与 GPU 间通信能力。
为大规模 AI 而生
DGX B200 旨在支持从实验、模型训练到生产推理的完整 AI 开发生命周期。其高密度 GPU 架构适用于:
大语言模型(LLM)训练
LLM 推理与服务
生成式 AI 应用
基础模型开发
AI 模型微调
检索增强生成(RAG)
AI 智能体与推理类工作负载
多模态 AI
自然语言处理
计算机视觉
机器学习
科学计算
高性能计算(HPC)
NVIDIA Blackwell 架构
DGX B200 采用 NVIDIA Blackwell GPU,专为现代 AI 迅速增长的算力需求而设计。Blackwell 架构为大型模型、复杂数据集以及计算密集型生成式 AI 工作负载提供先进的 GPU 加速能力。
对于既需要大量 GPU 算力与内存资源、又希望维持紧密集成的多 GPU 环境的组织而言,该平台尤具价值。
高带宽 NVLink 互连
DGX B200 平台的核心组成部分是其高速 NVLink GPU 互连。通过实现系统内 GPU 之间的快速通信,NVLink 有助于加速那些频繁进行 GPU 间数据交换的工作负载。
该架构对分布式 LLM 训练、微调和大规模推理尤为有益,可帮助降低通信开销并提升多 GPU 工作负载的效率。
企业级 AI 基础设施
NVIDIA DGX B200 系统专为企业数据中心、AI 工厂、云服务提供商、科研机构以及构建大规模 AI 基础设施的组织而设计。
一体化的 DGX 方案为 AI 开发与部署提供了现成基础,使组织能够将计算、内存、网络与 GPU 加速整合到一个专门构建的平台之中。
理想的 AI 训练与推理平台
从训练基础模型到部署生产级 AI 服务,DGX B200 专为需要大量加速器资源的高要求工作负载而打造。
组织可利用 DGX B200 基础设施构建面向生成式 AI、企业级 LLM、AI 智能体、推荐系统、计算机视觉、科学研究和高级分析的平台。
核心亮点
NVIDIA DGX B200 AI 系统
NVIDIA Blackwell 架构
多 GPU 高性能计算平台
高带宽 GPU 显存
先进的 NVLink GPU 互连
专为 LLM 训练与推理设计
针对生成式 AI 与基础模型优化
支持微调、RAG、AI 智能体与多模态工作负载
适用于企业 AI 与 HPC
面向大规模 AI 基础设施与 AI 工厂部署而设计
凭借 NVIDIA Blackwell GPU、高带宽显存与 NVLink 互连的组合,NVIDIA DGX B200 为希望在企业级规模上训练、微调和部署下一代 AI 模型的组织提供了强大基础。
常见问题
你们提供用于 AI 模型训练和推理的 GPU 服务器吗?
GPU 服务器的交付周期大约是多久?
你们为 GPU 基础设施提供融资方案吗?
我如何申请咨询或报价?
准备好开始了吗?
构建您的 AI 基础设施 信心十足
与我们的企业基础设施团队交流。获取专家指导、GPU 报价以及定制部署方案——无需任何承诺。