AI Servers
خادم ذكاء اصطناعي بـ8 وحدات معالجة رسومات
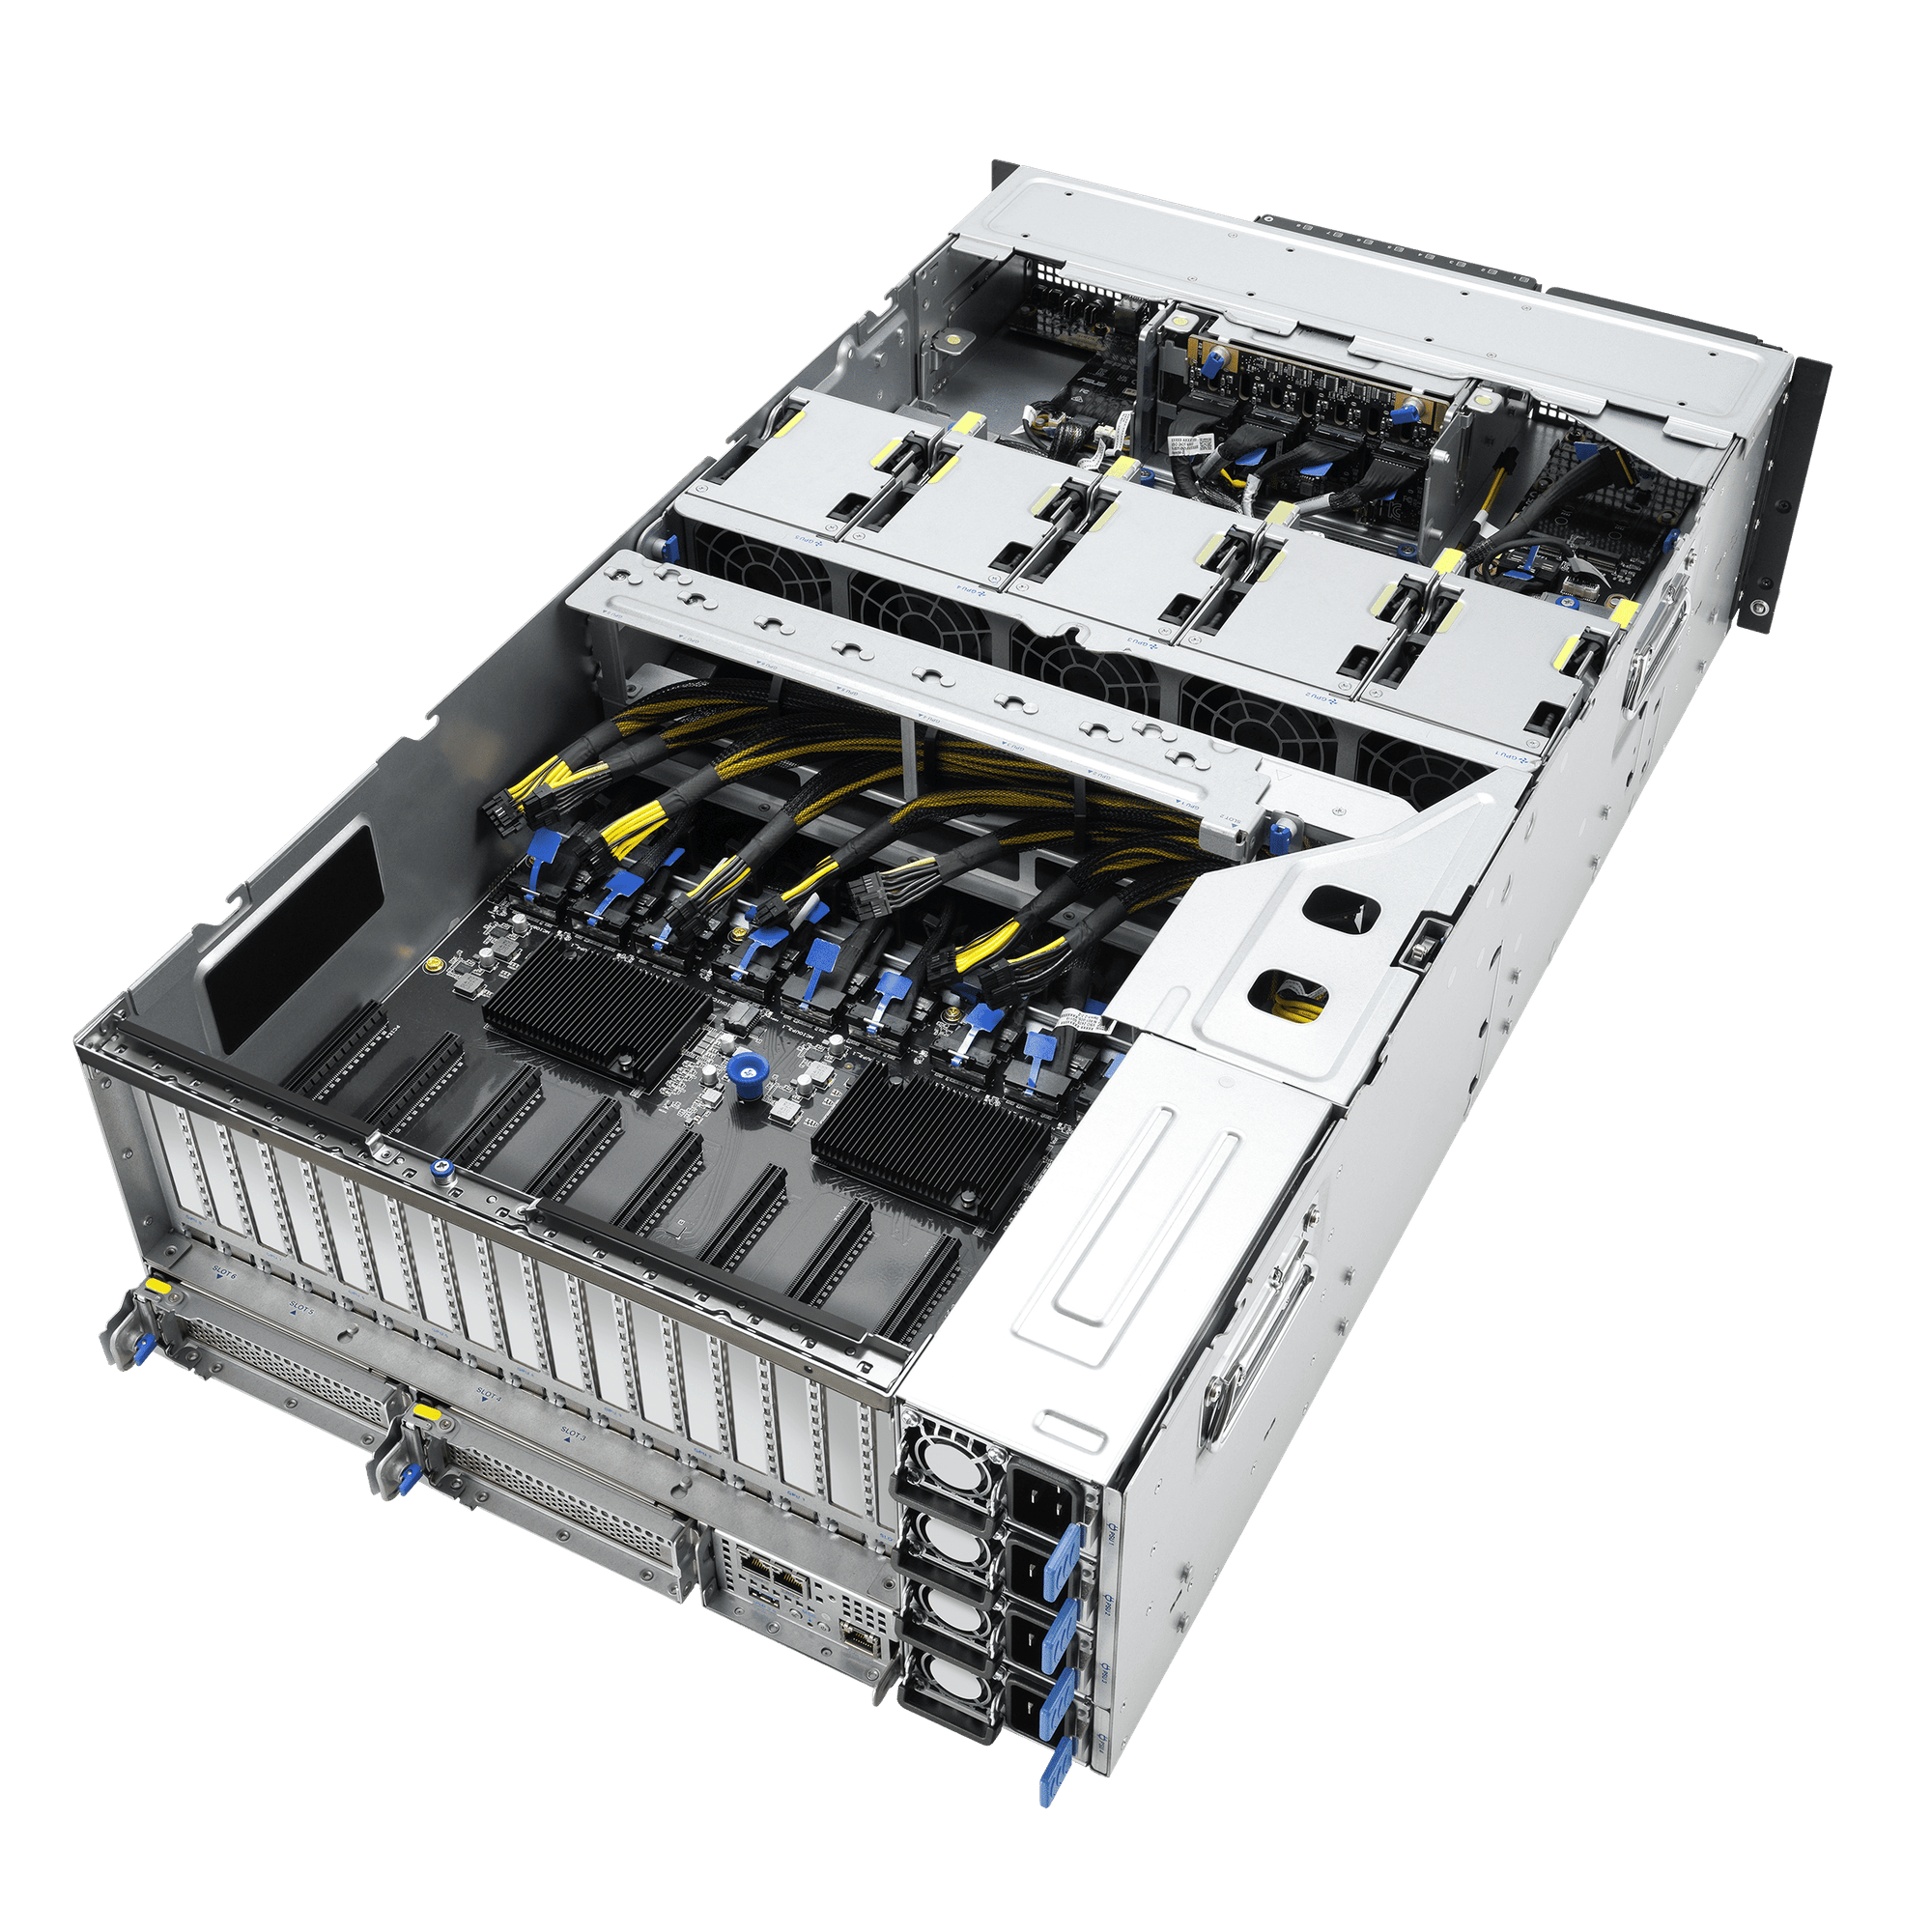
ما يصل إلى 8 وحدات معالجة رسومات NVIDIA، بما فيها H200 NVL وRTX PRO 6000 Blackwell، في خادم واحد مع معالجَي AMD EPYC 9005 لتحقيق توازن بين أحمال المعالج ووحدة معالجة الرسومات.
المواصفات الرئيسية
أحمال العمل المثالية
LLM Training
Train large language models with 8x GPU parallelism.
Multi-Model Serving
Serve multiple AI models simultaneously across 8 independent GPUs.
المواصفات الفنية
| Chassis | 4U or 8U Rackmount |
|---|---|
| Memory | Up to 3 TB DDR5 |
| Networking | Up to 4x 400 Gb |
شغّل أعباء عمل الذكاء الاصطناعي الأكثر تطلبًا باستخدام خادم ذكاء اصطناعي بـ 8 وحدات معالجة رسومية مصمم لتدريب النماذج اللغوية الكبيرة على نطاق واسع، والاستدلال، والضبط الدقيق، والذكاء الاصطناعي التوليدي، والحوسبة عالية الأداء. من خلال دمج ثماني وحدات GPU في نظام واحد عالي الكثافة، توفر هذه الخوادم قدرة الحوسبة وموارد الذاكرة اللازمة للذكاء الاصطناعي المؤسسي المتقدم، والنماذج اللغوية الكبيرة، والحوسبة العلمية، وتطبيقات الذكاء الاصطناعي على مستوى الإنتاج.
صُمم خادم الذكاء الاصطناعي بـ 8 وحدات GPU للمؤسسات التي تحتاج إلى أداء GPU كبير ضمن منصة خادم واحدة. ومقارنةً بالتكوينات الأصغر ذات وحدة GPU واحدة أو وحدتين أو أربع وحدات، يوفر النظام ذو الثماني وحدات كثافة مسرّعات أكبر ويمكّن أعباء العمل عالية التوازي من العمل بكفاءة عبر عدة وحدات GPU.
مصمم لأعباء عمل الذكاء الاصطناعي واسعة النطاق
تُعد الخوادم ذات الثماني وحدات GPU مناسبة بشكل خاص لأعباء العمل المتطلبة مثل:
تدريب النماذج اللغوية الكبيرة (LLM)
الاستدلال وتقديم خدمات النماذج اللغوية الكبيرة
الذكاء الاصطناعي التوليدي
تطوير النماذج الأساسية
الضبط الدقيق لنماذج الذكاء الاصطناعي
التعلم المعزز
التوليد المعزز بالاسترجاع (RAG)
وكلاء الذكاء الاصطناعي ونماذج الاستدلال المنطقي
الذكاء الاصطناعي متعدد الوسائط
الرؤية الحاسوبية
معالجة اللغة الطبيعية
الحوسبة العلمية
الحوسبة عالية الأداء (HPC)
التحليلات المسرّعة بوحدات GPU
بنية متعددة الوحدات عالية الكثافة
يوفر خادم بـ 8 وحدات GPU بيئة متكاملة بإحكام يمكن فيها لعدة مسرّعات العمل معًا على أعباء عمل ذكاء اصطناعي متوازية. وبحسب المنصة المختارة، يمكن لتقنيات الربط البيني بين وحدات GPU توفير اتصال عالي النطاق الترددي بينها، مما يساعد على تقليل اختناقات الاتصال في التدريب الموزع وغيره من التطبيقات متعددة الوحدات.
تتميز هذه البنية بقيمة خاصة لنماذج الذكاء الاصطناعي الكبيرة وأعباء العمل كثيفة الاستهلاك للذاكرة التي تستفيد من عمل عدة وحدات GPU كمنصة حوسبة منسّقة.
بنية تحتية للذكاء الاصطناعي المؤسسي
تشكّل خوادم الذكاء الاصطناعي بـ 8 وحدات GPU أساسًا ممتازًا لعناقيد الذكاء الاصطناعي المؤسسية، ومصانع الذكاء الاصطناعي، والسحابات الخاصة للذكاء الاصطناعي، ومختبرات البحث، والجامعات، ومزودي الخدمات السحابية، وبيئات الحوسبة عالية الأداء.
يمكن للمؤسسات نشر هذه الأنظمة لتطوير النماذج والتجريب، إضافةً إلى الاستدلال الإنتاجي وتطبيقات الذكاء الاصطناعي المؤسسية. كما يمكن لكثافة وحدات GPU العالية أن تساعد في دمج موارد الحوسبة ضمن عدد أقل من الأنظمة المادية، بحسب متطلبات أعباء العمل والبنية التحتية.
تكوينات GPU مرنة
يمكن تكوين خادم الذكاء الاصطناعي بـ 8 وحدات GPU بأجيال وفئات مختلفة من المسرّعات لتلبية متطلبات محددة تتعلق بذاكرة GPU، وأداء الحوسبة، واستهلاك الطاقة، وتوافق أعباء العمل.
وبحسب المنصة، قد تدعم التكوينات تقنيات ربط بيني متقدمة لوحدات GPU، وشبكات فائقة السرعة، وذاكرة نظام كبيرة، وتخزينًا محليًا سريعًا لتكوين أساس بنية تحتية متكامل لأعباء عمل الذكاء الاصطناعي المتطلبة.
أبرز المزايا
تكوين خادم ذكاء اصطناعي بـ 8 وحدات GPU
بنية متعددة الوحدات عالية الكثافة
مصمم لتدريب النماذج اللغوية الكبيرة والاستدلال
مثالي للذكاء الاصطناعي التوليدي والنماذج الأساسية
يدعم الضبط الدقيق وRAG ووكلاء الذكاء الاصطناعي وأعباء العمل متعددة الوسائط
قدرة حوسبة وذاكرة عالية لوحدات GPU
مناسب لبيئات الذكاء الاصطناعي المؤسسي والحوسبة عالية الأداء
مصمم لأعباء العمل المتوازية المتطلبة
تكوينات مرنة لوحدات GPU والشبكات والتخزين والنظام
أساس متين لبنية تحتية قابلة للتوسع للذكاء الاصطناعي
سواء كنت تدرّب نماذج لغوية كبيرة، أو تنشر استدلالًا عالي الإنتاجية، أو تطوّر تطبيقات ذكاء اصطناعي توليدي، أو تشغّل أعباء عمل علمية متقدمة، فإن خادم الذكاء الاصطناعي بـ 8 وحدات GPU يوفر البنية التحتية للمسرّعات عالية الأداء اللازمة لدعم الذكاء الاصطناعي الحديث على نطاق واسع.
الأسئلة الشائعة
هل توفّرون خوادم GPU لتدريب نماذج الذكاء الاصطناعي والاستدلال؟
ما هي مُدد التوريد المتوقعة لخوادم GPU؟
هل توفّرون تمويلاً لبنية وحدات معالجة الرسومات (GPU)؟
كيف يمكنني طلب استشارة أو عرض سعر؟
هل أنت مستعد للبدء؟
ابنِ بنيتك التحتية للذكاء الاصطناعي بكل ثقة
تحدّث إلى فريق البنية التحتية للمؤسسات لدينا. احصل على إرشادات الخبراء، وأسعار GPU، وخطة نشر مخصصة — دون أي التزام.