NVIDIA DGX
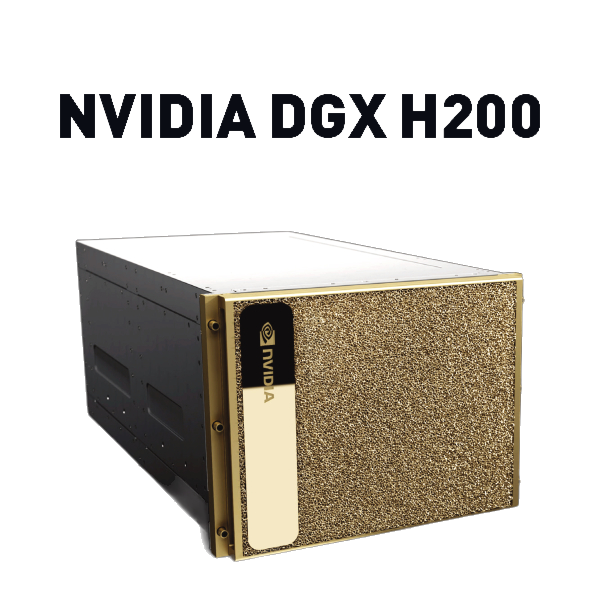
NVIDIA DGX H200
حاسوب فائق للذكاء الاصطناعي مثبت الجدارة من الجيل Hopper مع 8 وحدات معالجة رسومية H200 وذاكرة HBM3e بسعة 1.1 TB — الحصان الرابح لتدريب واستدلال النماذج اللغوية الكبيرة في المؤسسات بمُدد توريد أقصر.
المواصفات الرئيسية
أحمال العمل المثالية
LLM Inference at Scale
141 GB per GPU lets 70B+ models run without aggressive sharding.
Enterprise Fine-Tuning
Domain adaptation of open-weight models on-premises.
المواصفات الفنية
| CPU | 2x Intel Xeon Platinum 8480C |
|---|---|
| GPU | 8x NVIDIA H200 SXM 141 GB |
| System Memory | 2 TB DDR5 |
| Networking | 8x 400 Gb InfiniBand |
سرّع أعباء عمل الذكاء الاصطناعي المؤسسي مع حاسوب فائق للذكاء الاصطناعي من الجيل Hopper مثبت الجدارة، مدعوم بـ 8 وحدات معالجة رسومية NVIDIA H200 و1.1 TB من ذاكرة HBM3e. صُممت هذه المنصة لتكون حصان عمل عالي الأداء لتدريب نماذج اللغة الكبيرة (LLM) الصعبة، والضبط الدقيق، والاستدلال، وأعباء عمل الذكاء الاصطناعي التوليدي، وهي توفر كثافة الحوسبة وسعة ذاكرة وحدات المعالجة الرسومية وقابلية التوسع التي تتطلبها البنية التحتية الحديثة للذكاء الاصطناعي.
مبني حول وحدات NVIDIA H200، يجمع النظام بين أداء حوسبة رسومية هائل وذاكرة HBM3e عالية النطاق الترددي للتعامل بكفاءة مع أعباء العمل كثيفة الاستهلاك للذاكرة. ومع ثماني وحدات H200 في نظام واحد، يمكن للمؤسسات دمج مهام الذكاء الاصطناعي الصعبة، وتقليل تعقيد البنية التحتية، وتسريع تطوير النماذج من التجريب والضبط الدقيق وصولاً إلى الاستدلال الإنتاجي.
توفر ذاكرة HBM3e الإجمالية البالغة 1.1 TB سعة كبيرة للنماذج الضخمة ومجموعات البيانات الواسعة والاستدلال عالي الإنتاجية وأعباء التدريب المعقدة. وهذا يجعل المنصة مناسبة بشكل خاص للمؤسسات التي تشغّل نماذج لغوية كبيرة مؤسسية، وتطبيقات ذكاء اصطناعي توليدي، والتوليد المعزز بالاسترجاع (RAG)، ووكلاء الذكاء الاصطناعي، ومعالجة اللغة الطبيعية، والرؤية الحاسوبية، وغيرها من أعباء العمل كثيفة الاستخدام للمعالجات الرسومية.
مصمم لتدريب واستدلال نماذج اللغة الكبيرة في المؤسسات
سواء كنت تدرّب النماذج من الصفر، أو تضبط نماذج أساس قائمة، أو تنشر نماذج لغوية كبيرة على نطاق واسع، يوفر هذا الخادم المزوّد بـ 8 وحدات NVIDIA H200 أساساً قوياً للذكاء الاصطناعي المؤسسي. وتتيح كثافته العالية من المعالجات الرسومية للمؤسسات تشغيل أعباء عمل كثيفة حسابياً مع الاستفادة من مساحة الذاكرة الكبيرة المتاحة عبر النظام.
تشمل أعباء العمل النموذجية:
تدريب نماذج اللغة الكبيرة (LLM)
الضبط الدقيق وضبط التعليمات لنماذج LLM
تطوير نماذج الذكاء الاصطناعي التوليدي
استدلال LLM عالي الأداء
أعباء عمل RAG ووكلاء الذكاء الاصطناعي
تدريب النماذج القائمة على Transformer
معالجة اللغة الطبيعية
الرؤية الحاسوبية والذكاء الاصطناعي متعدد الوسائط
البحث والتطوير في الذكاء الاصطناعي
تعلم الآلة في المؤسسات
تقييم النماذج وقياس الأداء المرجعي
بنية معمارية مثبتة من الجيل Hopper
استناداً إلى معمارية NVIDIA Hopper، صُمم هذا الحاسوب الفائق للذكاء الاصطناعي لبيئات الحوسبة المتسارعة الصعبة. ويخلق الجمع بين 8 وحدات H200 و1.1 TB من HBM3e منصة عالية الكثافة للمؤسسات التي تحتاج إلى موارد رسومية كبيرة دون بناء عنقود موزّع ضخم من الصفر.
بالنسبة لفرق الذكاء الاصطناعي المؤسسية، يمكن لهذه المعمارية أن تختصر المسار من نشر البنية التحتية إلى أعباء عمل ذكاء اصطناعي منتجة. والمنصة جذابة بشكل خاص للمؤسسات التي تبحث عن حل بنية تحتية رسومية جاهز للنشر بمهل تسليم أقصر، ما يتيح للفرق توسيع مبادرات الذكاء الاصطناعي بسرعة أكبر وتجنّب التأخيرات غير الضرورية المرتبطة بتصميم وتجميع عناقيد GPU مخصصة.
حصان عمل عالي الأداء للبنية التحتية للذكاء الاصطناعي
من الشركات الناشئة وفرق البحث إلى المؤسسات الكبرى، يوفر هذا الحاسوب الفائق المزوّد بـ H200 موارد الحوسبة والذاكرة اللازمة لدعم أعباء عمل الذكاء الاصطناعي المتزايدة الصعوبة. ويقدم تكوينه المكوّن من ثماني وحدات معالجة رسومية توازناً قوياً بين كثافة المعالجات الرسومية وسعة الذاكرة والأداء وبساطة التشغيل.
إذا كانت مؤسستك تبحث عن خوادم NVIDIA H200، أو أنظمة ذكاء اصطناعي بثماني وحدات معالجة رسومية، أو بنية تحتية رسومية للمؤسسات، أو خوادم تدريب نماذج اللغة الكبيرة، أو حوسبة ذكاء اصطناعي عالية الأداء، فإن هذه المنصة توفر أساساً قوياً لنشر تطبيقات الذكاء الاصطناعي من الجيل التالي.
أبرز المزايا:
8 وحدات معالجة رسومية NVIDIA H200
1.1 TB إجمالي ذاكرة HBM3e
معمارية NVIDIA من الجيل Hopper
مصمم لتدريب واستدلال نماذج اللغة الكبيرة في المؤسسات
مثالي لأعباء الذكاء الاصطناعي التوليدي ونماذج الأساس
مناسب للضبط الدقيق وRAG ووكلاء الذكاء الاصطناعي وأعباء تعلم الآلة
بنية تحتية رسومية عالية الكثافة لبيئات المؤسسات
مهلة تسليم أقصر مقارنة بعمليات نشر البنية التحتية المخصصة الطويلة
مبني كحصان عمل موثوق للحوسبة الفائقة في أعباء العمل الصعبة
سواء كان الهدف تسريع تطوير نماذج اللغة الكبيرة، أو الضبط الدقيق، أو الاستدلال، أو الذكاء الاصطناعي التوليدي، أو تعلم الآلة المؤسسي، يوفر هذا الحاسوب الفائق المزوّد بـ 8 وحدات H200 البنية التحتية الرسومية عالية الذاكرة وعالية الأداء اللازمة لنقل مشاريع الذكاء الاصطناعي الصعبة من التطوير إلى الإنتاج.
الأسئلة الشائعة
هل توفّرون خوادم GPU لتدريب نماذج الذكاء الاصطناعي والاستدلال؟
ما هي مُدد التوريد المتوقعة لخوادم GPU؟
هل توفّرون تمويلاً لبنية وحدات معالجة الرسومات (GPU)؟
كيف يمكنني طلب استشارة أو عرض سعر؟
هل أنت مستعد للبدء؟
ابنِ بنيتك التحتية للذكاء الاصطناعي بكل ثقة
تحدّث إلى فريق البنية التحتية للمؤسسات لدينا. احصل على إرشادات الخبراء، وأسعار GPU، وخطة نشر مخصصة — دون أي التزام.