AI Servers
AIサーバー 8 GPU
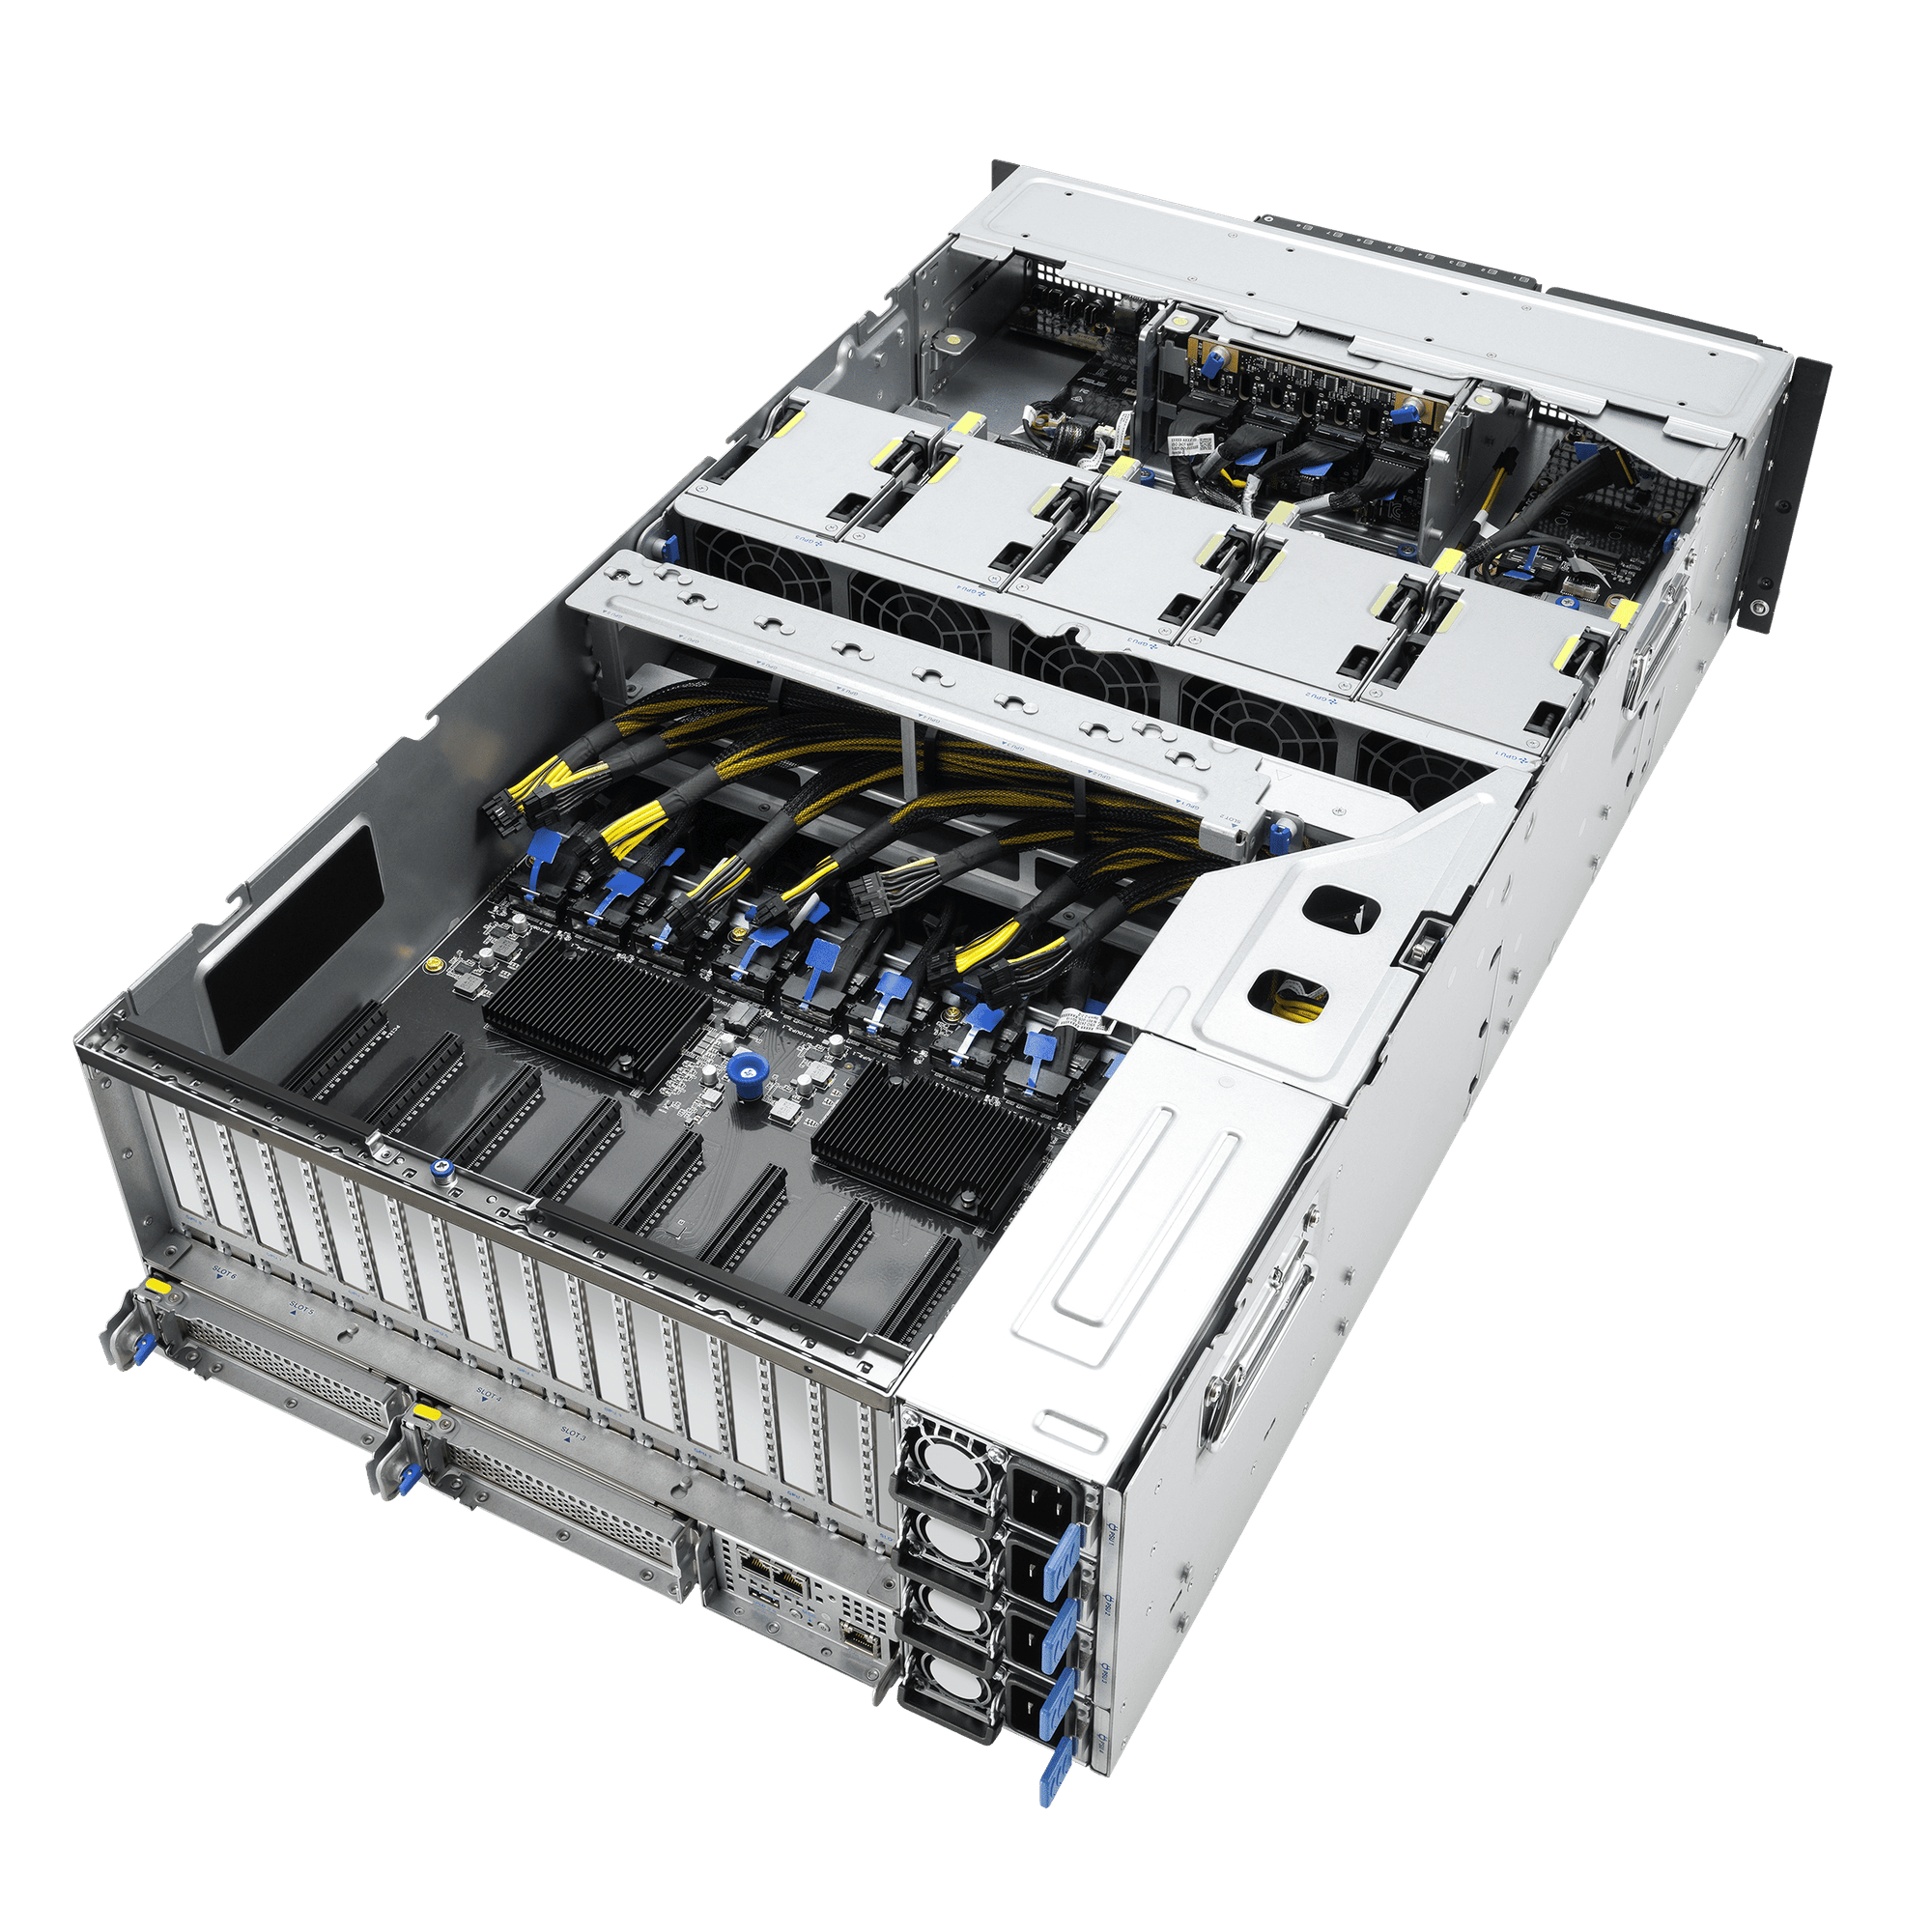
H200 NVLやRTX PRO 6000 Blackwellを含む最大8基のNVIDIA GPUを1台のサーバーに搭載し、デュアルAMD EPYC 9005プロセッサーでCPUとGPUのワークロードをバランスよく処理します。
主な仕様
適したワークロード
LLM Training
Train large language models with 8x GPU parallelism.
Multi-Model Serving
Serve multiple AI models simultaneously across 8 independent GPUs.
技術仕様
| Chassis | 4U or 8U Rackmount |
|---|---|
| Memory | Up to 3 TB DDR5 |
| Networking | Up to 4x 400 Gb |
大規模なLLMトレーニング、推論、ファインチューニング、生成AI、ハイパフォーマンスコンピューティング向けに設計された8基GPU搭載AIサーバーで、要求の厳しい人工知能ワークロードを推進します。1台の高密度システムに8基のGPUを統合することで、これらのサーバーは高度なエンタープライズAI、大規模言語モデル、科学技術計算、本番規模のAIアプリケーションに必要な演算能力とメモリリソースを提供します。
8基GPU搭載AIサーバーは、単一のサーバープラットフォーム内で十分なGPU性能を必要とする組織のために設計されています。より小規模な1 GPU、2 GPU、4 GPU構成と比較して、8基GPUシステムはより高いアクセラレータ密度を提供し、高度に並列化されたワークロードを複数のGPUにわたって効率的に実行できます。
大規模AIワークロード向けに構築
8基GPUサーバーは、特に次のような要求の厳しいワークロードに適しています。
大規模言語モデル(LLM)のトレーニング
LLMの推論とサービング
生成AI
基盤モデルの開発
AIモデルのファインチューニング
強化学習
検索拡張生成(RAG)
AIエージェントと推論モデル
マルチモーダルAI
コンピュータービジョン
自然言語処理
科学技術計算
ハイパフォーマンスコンピューティング(HPC)
GPUアクセラレーテッド分析
高密度マルチGPUアーキテクチャ
8基GPUサーバーは、複数のアクセラレータが並列AIワークロードで連携できる、緊密に統合された環境を提供します。選択するプラットフォームによっては、GPU相互接続技術によりGPU間の高帯域通信が可能となり、分散トレーニングやその他のマルチGPUアプリケーションにおける通信ボトルネックの低減に役立ちます。
このアーキテクチャは、協調した演算プラットフォームとして動作する複数のGPUの恩恵を受ける、大規模AIモデルやメモリ集約型ワークロードにとって特に価値があります。
エンタープライズAIインフラストラクチャ
8基GPU搭載AIサーバーは、エンタープライズAIクラスター、AIファクトリー、プライベートAIクラウド、研究機関、大学、クラウドサービスプロバイダー、ハイパフォーマンスコンピューティング環境の優れた基盤となります。
組織はこれらのシステムを、モデル開発や実験だけでなく、本番推論やエンタープライズAIアプリケーションにも展開できます。その高いGPU密度は、ワークロードやインフラ要件に応じて、演算リソースをより少数の物理システムに集約するのにも役立ちます。
柔軟なGPU構成
8基GPU搭載AIサーバーは、GPUメモリ、演算性能、消費電力、ワークロード互換性に関する固有の要件に応じて、さまざまな世代・クラスのアクセラレータで構成できます。
プラットフォームによっては、先進的なGPU相互接続技術、高速ネットワーク、大容量システムメモリ、高速ローカルストレージをサポートし、要求の厳しいAIワークロードのための完全なインフラ基盤を構築できます。
主なポイント
8基GPU搭載AIサーバー構成
高密度マルチGPUアーキテクチャ
LLMのトレーニングと推論向けに設計
生成AIおよび基盤モデルに最適
ファインチューニング、RAG、AIエージェント、マルチモーダルワークロードに対応
高いGPU演算能力とメモリ容量
エンタープライズAIおよびHPC環境に適合
要求の厳しい並列ワークロード向けに設計
柔軟なGPU、ネットワーク、ストレージ、システム構成
スケーラブルなAIインフラの強固な基盤
大規模言語モデルのトレーニング、高スループット推論の展開、生成AIアプリケーションの開発、高度な科学技術ワークロードの実行のいずれにおいても、8基GPU搭載AIサーバーは、現代のAIを大規模に支えるために必要な高性能アクセラレータインフラを提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。