GPU Servers
خوادم NVIDIA HGX H200
141 GB من HBM3e لكل وحدة معالجة رسومات — أي ما يقارب ضعف سعة H100، مما يتيح تشغيل نماذج أكبر في نظام واحد مع مدد توريد متاحة على نطاق واسع.
المواصفات الرئيسية
أحمال العمل المثالية
Large-Context Inference
Serve long-context models without excessive tensor parallelism.
المواصفات الفنية
| Form Factor | 8U air cooled |
|---|---|
| CPU | 2x Intel Xeon or AMD EPYC |
| Networking | 8x 400 Gb NDR InfiniBand |
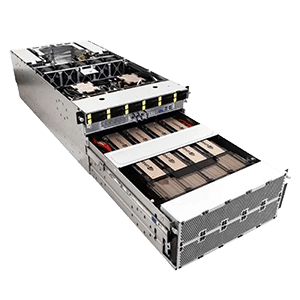
سرّع أعباء عمل الذكاء الاصطناعي والحوسبة عالية الأداء الأكثر تطلبًا مع خوادم NVIDIA HGX H200، المصممة خصيصًا لتدريب نماذج اللغة الكبيرة في المؤسسات، والضبط الدقيق، والاستدلال، والذكاء الاصطناعي التوليدي، والحوسبة المتسارعة. وبالجمع بين منصة وحدات معالجة الرسوميات NVIDIA H200 وتقنية الربط البيني عالي النطاق الترددي بين وحدات المعالجة الرسومية، توفر أنظمة HGX H200 أداء الحوسبة وسعة ذاكرة وحدات المعالجة الرسومية اللازمة لبنية الذكاء الاصطناعي الحديثة.
صُممت خوادم HGX H200 للمؤسسات التي تنشر تطبيقات ذكاء اصطناعي واسعة النطاق، وهي تقدم بنية متعددة وحدات المعالجة الرسومية قوية لأعباء العمل التي تتطلب ذاكرة GPU كبيرة، وإنتاجية عالية، واتصالًا سريعًا بين وحدات المعالجة الرسومية. وتشكل هذه الأنظمة أساسًا مثاليًا لعناقيد الذكاء الاصطناعي المؤسسية، ومصانع الذكاء الاصطناعي، وبيئات البحث، والبنية التحتية للحوسبة عالية الأداء.
مبنية لأعباء عمل الذكاء الاصطناعي واسعة النطاق
صُممت وحدات NVIDIA H200 لتطبيقات الذكاء الاصطناعي والحوسبة عالية الأداء كثيفة الاستخدام للذاكرة. يمكن لخادم HGX H200 دمج عدة وحدات H200 في نظام مترابط بإحكام، مما يجعله مناسبًا تمامًا لأعباء العمل كثيفة الحوسبة مثل:
تدريب نماذج اللغة الكبيرة (LLM)
استدلال نماذج اللغة الكبيرة وتقديمها
الذكاء الاصطناعي التوليدي
تطوير النماذج الأساسية
الضبط الدقيق لنماذج الذكاء الاصطناعي
التوليد المعزّز بالاسترجاع (RAG)
وكلاء الذكاء الاصطناعي وأعباء الاستدلال المنطقي
الذكاء الاصطناعي متعدد الوسائط
معالجة اللغة الطبيعية
الرؤية الحاسوبية
الحوسبة العلمية
الحوسبة عالية الأداء (HPC)
بنية تحتية لوحدات معالجة رسومية عالية النطاق الترددي
صُممت منصات HGX H200 حول وصلات ربط بيني عالية الأداء بين وحدات المعالجة الرسومية تتيح اتصالًا فعالًا بين الوحدات داخل الخادم. وهذا مهم بصفة خاصة لأعباء عمل الذكاء الاصطناعي الموزعة التي يعتمد فيها تدريب النماذج والاستدلال على تبادل متكرر للبيانات بين المسرّعات.
والنتيجة هي منصة خوادم ذكاء اصطناعي متعددة وحدات المعالجة الرسومية عالية القدرة، مصممة لإبقاء أعباء العمل المتطلبة تسير بكفاءة مع توفير موارد وحدات المعالجة الرسومية اللازمة لنماذج ذكاء اصطناعي متزايدة الضخامة.
خوادم NVIDIA H200 الجاهزة للمؤسسات
تتوفر خوادم NVIDIA HGX H200 عبر كبرى شركات تصنيع الخوادم الأصلية وشركاء الأنظمة، مما يمنح المؤسسات خيارات مرنة لنشر بنية تحتية مؤسسية لوحدات المعالجة الرسومية. ويمكن أن تكون لبنات بناء لعناقيد ذكاء اصطناعي مخصصة، وسحابات ذكاء اصطناعي خاصة، وبيئات بحثية، ومنصات استدلال بحجم الإنتاج.
سواء كنت توسّع عنقود وحدات معالجة رسومية قائمًا أو تبني بيئة بنية تحتية جديدة للذكاء الاصطناعي، توفر خوادم NVIDIA HGX H200 منصة قوية لتسريع تطوير ونشر تطبيقات الذكاء الاصطناعي من الجيل التالي.
أبرز المزايا
منصة خوادم NVIDIA HGX H200
بنية متعددة وحدات المعالجة الرسومية للذكاء الاصطناعي المؤسسي
وحدات NVIDIA H200 بذاكرة GPU عالية النطاق الترددي
ربط بيني فائق السرعة بين وحدات المعالجة الرسومية
مُحسَّنة لتدريب نماذج اللغة الكبيرة والاستدلال
مثالية للذكاء الاصطناعي التوليدي والنماذج الأساسية
مناسبة للضبط الدقيق وRAG ووكلاء الذكاء الاصطناعي وأعباء العمل متعددة الوسائط
مصممة لمراكز بيانات الذكاء الاصطناعي وبيئات HPC
أساس بمستوى المؤسسات لبنية تحتية قابلة للتوسع لوحدات المعالجة الرسومية
متوفرة عبر منظومات شركاء OEM وNVIDIA
من تدريب نماذج اللغة الكبيرة والذكاء الاصطناعي التوليدي إلى الاستدلال الإنتاجي والحوسبة العلمية، توفر خوادم NVIDIA HGX H200 البنية التحتية عالية الأداء لوحدات المعالجة الرسومية المطلوبة لتشغيل بعض أكثر أعباء العمل المتسارعة تطلبًا اليوم.
الأسئلة الشائعة
هل توفّرون خوادم GPU لتدريب نماذج الذكاء الاصطناعي والاستدلال؟
ما هي مُدد التوريد المتوقعة لخوادم GPU؟
هل توفّرون تمويلاً لبنية وحدات معالجة الرسومات (GPU)؟
كيف يمكنني طلب استشارة أو عرض سعر؟
هل أنت مستعد للبدء؟
ابنِ بنيتك التحتية للذكاء الاصطناعي بكل ثقة
تحدّث إلى فريق البنية التحتية للمؤسسات لدينا. احصل على إرشادات الخبراء، وأسعار GPU، وخطة نشر مخصصة — دون أي التزام.