GPU Servers
NVIDIA HGX H200 サーバー
GPU あたり 141 GB HBM3e — H100 のほぼ 2 倍の容量で、より大きなモデルを単一システムで実行可能。短納期で広く供給。
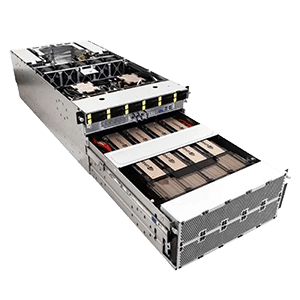
主な仕様
適したワークロード
Large-Context Inference
Serve long-context models without excessive tensor parallelism.
技術仕様
| Form Factor | 8U air cooled |
|---|---|
| CPU | 2x Intel Xeon or AMD EPYC |
| Networking | 8x 400 Gb NDR InfiniBand |
NVIDIA HGX H200 サーバーは、企業向けのLLMトレーニング、ファインチューニング、推論、生成AI、アクセラレーテッドコンピューティングのために設計されており、要求の厳しいAIおよびハイパフォーマンスコンピューティングのワークロードを加速します。NVIDIA H200 GPUプラットフォームと高帯域幅のGPU相互接続技術を組み合わせたHGX H200システムは、現代のAIインフラに求められる演算性能とGPUメモリ容量を提供します。
大規模なAIアプリケーションを展開する組織向けに設計されたHGX H200サーバーは、大容量のGPUメモリ、高いスループット、高速なGPU間通信を必要とするワークロードに強力なマルチGPUアーキテクチャを提供します。これらのシステムは、企業向けAIクラスター、AIファクトリー、研究環境、ハイパフォーマンスコンピューティング基盤の理想的な土台となります。
大規模AIワークロードのために構築
NVIDIA H200 GPUは、メモリ集約型のAIおよびHPCアプリケーション向けに設計されています。HGX H200サーバーは複数のH200 GPUを密結合したシステムに統合でき、次のような計算負荷の高いワークロードに最適です。
大規模言語モデル(LLM)のトレーニング
LLMの推論とサービング
生成AI
基盤モデルの開発
AIモデルのファインチューニング
検索拡張生成(RAG)
AIエージェントと推論ワークロード
マルチモーダルAI
自然言語処理
コンピュータービジョン
科学技術計算
ハイパフォーマンスコンピューティング(HPC)
高帯域幅のGPUインフラ
HGX H200プラットフォームは、サーバー内のGPU間で効率的な通信を可能にする高性能なGPU相互接続を中心に設計されています。これは、モデルのトレーニングと推論がアクセラレーター間の頻繁なデータ交換に依存する分散型AIワークロードにおいて特に重要です。
その結果、ますます大規模化するAIモデルに必要なGPUリソースを提供しながら、要求の厳しいワークロードを効率的に処理し続ける、非常に高性能なマルチGPU AIサーバープラットフォームが実現します。
エンタープライズ対応のNVIDIA H200サーバー
NVIDIA HGX H200サーバーは主要なサーバーOEMおよびシステムパートナーを通じて提供され、企業向けGPUインフラを展開するための柔軟な選択肢を組織にもたらします。専用AIクラスター、プライベートAIクラウド、研究環境、本番規模の推論プラットフォームの構成要素として活用できます。
既存のGPUクラスターを拡張する場合でも、新たなAIインフラ環境を構築する場合でも、NVIDIA HGX H200サーバーは次世代AIアプリケーションの開発と展開を加速する強力なプラットフォームを提供します。
主なポイント
NVIDIA HGX H200 サーバープラットフォーム
企業向けAIのためのマルチGPUアーキテクチャ
高帯域幅GPUメモリを備えたNVIDIA H200 GPU
高速なGPU間相互接続
LLMのトレーニングと推論に最適化
生成AIおよび基盤モデルに最適
ファインチューニング、RAG、AIエージェント、マルチモーダルワークロードに対応
AIデータセンターおよびHPC環境向けに設計
スケーラブルなGPUインフラのためのエンタープライズグレードの基盤
OEMおよびNVIDIAパートナーエコシステムを通じて提供
LLMトレーニングや生成AIから本番環境の推論、科学技術計算まで、NVIDIA HGX H200サーバーは今日最も要求の厳しいアクセラレーテッドワークロードを実行するために必要な高性能GPUインフラを提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。