NVIDIA DGX
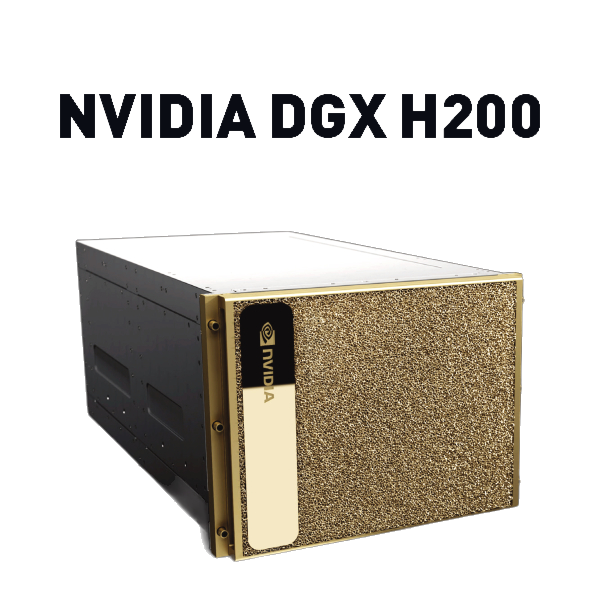
NVIDIA DGX H200
Superordinateur IA de génération Hopper éprouvé, avec 8 GPU H200 et 1,1 To de HBM3e — la référence pour l'entraînement et l'inférence de LLM en entreprise, avec des délais de livraison plus courts.
Caractéristiques principales
Charges de travail idéales
LLM Inference at Scale
141 GB per GPU lets 70B+ models run without aggressive sharding.
Enterprise Fine-Tuning
Domain adaptation of open-weight models on-premises.
Spécifications techniques
| CPU | 2x Intel Xeon Platinum 8480C |
|---|---|
| GPU | 8x NVIDIA H200 SXM 141 GB |
| System Memory | 2 TB DDR5 |
| Networking | 8x 400 Gb InfiniBand |
Accélérez vos charges de travail d'IA d'entreprise avec un superordinateur d'IA éprouvé de génération Hopper, propulsé par 8 GPU NVIDIA H200 et 1,1 To de mémoire HBM3e. Conçue comme une machine de travail haute performance pour l'entraînement, le réglage fin (fine-tuning), l'inférence de grands modèles de langage (LLM) et les charges d'IA générative les plus exigeantes, cette plateforme offre la densité de calcul, la capacité mémoire GPU et l'évolutivité qu'exige une infrastructure d'IA moderne.
Construit autour des GPU NVIDIA H200, le système associe une puissance de calcul GPU massive à une mémoire HBM3e à haute bande passante pour traiter efficacement les charges d'IA gourmandes en mémoire. Avec huit GPU H200 dans un seul système, les entreprises peuvent consolider leurs travaux d'IA exigeants, réduire la complexité de leur infrastructure et accélérer le développement de modèles, de l'expérimentation et du fine-tuning jusqu'à l'inférence en production.
Les 1,1 To de mémoire GPU HBM3e totale offrent une capacité substantielle pour les grands modèles, les jeux de données volumineux, l'inférence à haut débit et les charges d'entraînement complexes. La plateforme convient donc particulièrement aux organisations exécutant des LLM d'entreprise, des applications d'IA générative, de la génération augmentée par récupération (RAG), des agents IA, du traitement du langage naturel, de la vision par ordinateur et d'autres charges intensives en GPU.
Conçu pour l'entraînement et l'inférence de LLM en entreprise
Que vous entraîniez des modèles depuis zéro, affiniez des modèles de fondation existants ou déployiez des LLM à grande échelle, ce serveur à 8 GPU NVIDIA H200 constitue une base puissante pour l'IA d'entreprise. Sa forte densité GPU permet d'exécuter des charges de travail intensives tout en tirant parti de la vaste empreinte mémoire disponible sur l'ensemble du système.
Charges de travail types :
Entraînement de grands modèles de langage (LLM)
Fine-tuning et instruction tuning de LLM
Développement de modèles d'IA générative
Inférence LLM haute performance
Charges RAG et agents IA
Entraînement de modèles basés sur les transformeurs
Traitement du langage naturel
Vision par ordinateur et IA multimodale
Recherche et développement en IA
Apprentissage automatique d'entreprise
Évaluation et benchmarking de modèles
Une architecture éprouvée de génération Hopper
Fondé sur l'architecture NVIDIA Hopper, ce superordinateur d'IA est conçu pour les environnements de calcul accéléré les plus exigeants. L'association de 8 GPU H200 et de 1,1 To de HBM3e crée une plateforme à haute densité pour les organisations qui ont besoin de ressources GPU importantes sans construire de zéro un vaste cluster distribué.
Pour les équipes d'IA en entreprise, cette architecture raccourcit le chemin entre le déploiement de l'infrastructure et la mise en production des charges d'IA. La plateforme est particulièrement attrayante pour les organisations à la recherche d'une solution d'infrastructure GPU prête à déployer avec des délais réduits, permettant aux équipes de faire évoluer plus vite leurs initiatives d'IA et d'éviter les retards liés à la conception et à l'assemblage de clusters GPU sur mesure.
Une machine de travail haute performance pour l'infrastructure d'IA
Des startups d'IA et équipes de recherche aux grandes entreprises, ce superordinateur GPU H200 fournit les ressources de calcul et de mémoire nécessaires pour soutenir des charges d'IA toujours plus exigeantes. Sa configuration à huit GPU offre un excellent équilibre entre densité GPU, capacité mémoire, performance et simplicité opérationnelle.
Si votre organisation recherche des serveurs NVIDIA H200, des systèmes d'IA à 8 GPU, une infrastructure GPU d'entreprise, des serveurs d'entraînement de LLM ou du calcul IA haute performance, cette plateforme constitue une base solide pour déployer des applications d'IA de nouvelle génération.
Points clés :
8 GPU NVIDIA H200
1,1 To de mémoire GPU HBM3e au total
Architecture NVIDIA de génération Hopper
Conçu pour l'entraînement et l'inférence de LLM en entreprise
Idéal pour l'IA générative et les charges liées aux modèles de fondation
Adapté au fine-tuning, au RAG, aux agents IA et aux charges de ML
Infrastructure GPU haute densité pour les environnements d'entreprise
Délais de livraison réduits par rapport aux longs déploiements d'infrastructures sur mesure
Conçu comme un superordinateur d'IA fiable pour les charges de calcul exigeantes
Que l'objectif soit d'accélérer le développement de LLM, le fine-tuning, l'inférence, l'IA générative ou l'apprentissage automatique d'entreprise, ce superordinateur d'IA à 8 GPU H200 fournit l'infrastructure GPU à haute mémoire et haute performance nécessaire pour faire passer les projets d'IA exigeants du développement à la production.
Questions fréquentes
Proposez-vous des serveurs GPU pour l'entraînement et l'inférence de modèles d'IA ?
Quels délais de livraison prévoir pour les serveurs GPU ?
Proposez-vous des solutions de financement pour l'infrastructure GPU ?
Comment demander une consultation ou un devis ?
Prêt à démarrer ?
Construisez votre infrastructure IA en toute confiance
Échangez avec notre équipe d'infrastructure d'entreprise. Bénéficiez de conseils d'experts, de tarifs GPU et d'un plan de déploiement sur mesure — sans engagement.