NVIDIA DGX
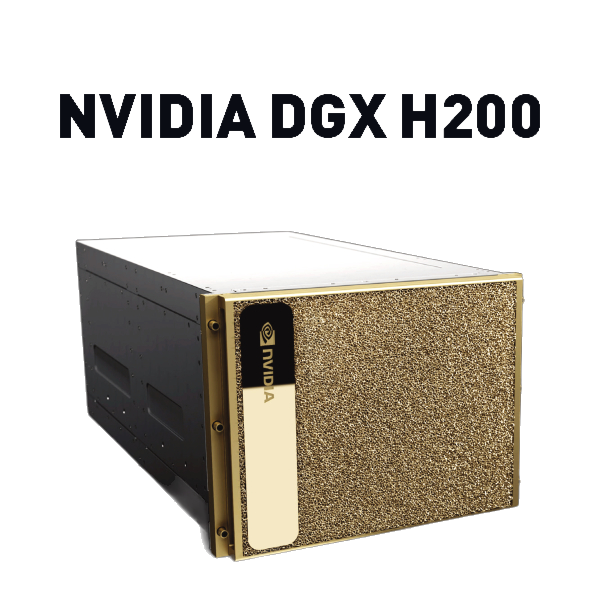
NVIDIA DGX H200
8基の H200 GPU と 1.1 TB の HBM3e を備えた実績ある Hopper 世代の AI スーパーコンピューター。短納期でエンタープライズの LLM トレーニングと推論を支える主力機です。
主な仕様
適したワークロード
LLM Inference at Scale
141 GB per GPU lets 70B+ models run without aggressive sharding.
Enterprise Fine-Tuning
Domain adaptation of open-weight models on-premises.
技術仕様
| CPU | 2x Intel Xeon Platinum 8480C |
|---|---|
| GPU | 8x NVIDIA H200 SXM 141 GB |
| System Memory | 2 TB DDR5 |
| Networking | 8x 400 Gb InfiniBand |
8基のNVIDIA H200 GPUと1.1 TBのHBM3eメモリを搭載した実績あるHopper世代のAIスーパーコンピューターで、エンタープライズAIワークロードを加速します。要求の厳しい大規模言語モデル(LLM)のトレーニング、ファインチューニング、推論、生成AIワークロード向けの高性能なワークホースとして設計され、最新のAIインフラに求められる計算密度、GPUメモリ容量、スケーラビリティを提供します。
NVIDIA H200 GPUを中核とする本システムは、大規模なGPU計算性能と高帯域幅のHBM3eメモリを組み合わせ、メモリ集約型のAIワークロードを効率的に処理します。1台のシステムに8基のH200 GPUを搭載することで、企業は要求の厳しいAIジョブを統合し、インフラの複雑さを軽減し、実験やファインチューニングから本番推論に至るまでのモデル開発を加速できます。
合計1.1 TBのHBM3e GPUメモリは、大規模モデル、膨大なデータセット、高スループット推論、複雑なトレーニングワークロードに十分な容量を提供します。これにより、エンタープライズLLM、生成AIアプリケーション、検索拡張生成(RAG)、AIエージェント、自然言語処理、コンピュータービジョンなど、GPU集約型ワークロードを実行する組織に特に適したプラットフォームとなります。
エンタープライズLLMのトレーニングと推論のために構築
モデルをゼロからトレーニングする場合も、既存の基盤モデルをファインチューニングする場合も、LLMを大規模に展開する場合も、この8基のNVIDIA H200 GPUサーバーはエンタープライズAIの強力な基盤となります。高いGPU密度により、システム全体で利用可能な大容量メモリを活かしながら、計算負荷の高いワークロードを実行できます。
代表的なワークロード:
大規模言語モデル(LLM)のトレーニング
LLMのファインチューニングおよび指示チューニング
生成AIモデルの開発
高性能なLLM推論
RAGおよびAIエージェントのワークロード
Transformerベースのモデルトレーニング
自然言語処理
コンピュータービジョンおよびマルチモーダルAI
AIの研究開発
エンタープライズ機械学習
モデル評価とベンチマーク
実績あるHopper世代アーキテクチャ
NVIDIA Hopperアーキテクチャをベースとする本AIスーパーコンピューターは、要求の厳しいアクセラレーテッドコンピューティング環境向けに設計されています。8基のH200 GPUと1.1 TBのHBM3eの組み合わせにより、大規模な分散クラスターを一から構築することなく、豊富なGPUリソースを必要とする組織に高密度なプラットフォームを提供します。
エンタープライズのAIチームにとって、このアーキテクチャはインフラ導入から実用的なAIワークロードまでの道のりを短縮します。特に、リードタイムの短い導入可能なGPUインフラソリューションを求める組織にとって魅力的であり、カスタムGPUクラスターの設計・構築に伴う不要な遅延を回避し、AI施策をより迅速に拡大できます。
AIインフラのための高性能ワークホース
AIスタートアップや研究チームから大企業まで、このH200 GPUスーパーコンピューターは、ますます高度化するAIワークロードを支える計算リソースとメモリリソースを提供します。8 GPU構成は、GPU密度、メモリ容量、性能、運用のシンプルさの優れたバランスを実現します。
NVIDIA H200サーバー、8 GPU搭載AIシステム、エンタープライズGPUインフラ、LLMトレーニングサーバー、高性能AIコンピューティングをお探しの組織にとって、本プラットフォームは次世代AIアプリケーション展開の強力な基盤となります。
主なポイント:
8基のNVIDIA H200 GPU
合計1.1 TBのHBM3e GPUメモリ
NVIDIA Hopper世代アーキテクチャ
エンタープライズLLMのトレーニングと推論向けに設計
生成AIおよび基盤モデルのワークロードに最適
ファインチューニング、RAG、AIエージェント、MLワークロードに対応
エンタープライズ環境向けの高密度GPUインフラ
長期化しがちなカスタムインフラ導入と比べて短いリードタイム
要求の厳しい計算ワークロードに応える信頼性の高いAIスーパーコンピューターのワークホース
LLM開発、ファインチューニング、推論、生成AI、エンタープライズ機械学習のいずれを加速する場合でも、この8基のH200搭載AIスーパーコンピューターは、要求の厳しいAIプロジェクトを開発から本番へ進めるために必要な大容量メモリと高性能のGPUインフラを提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。