GPU Servers
NVIDIA HGX B300 サーバー
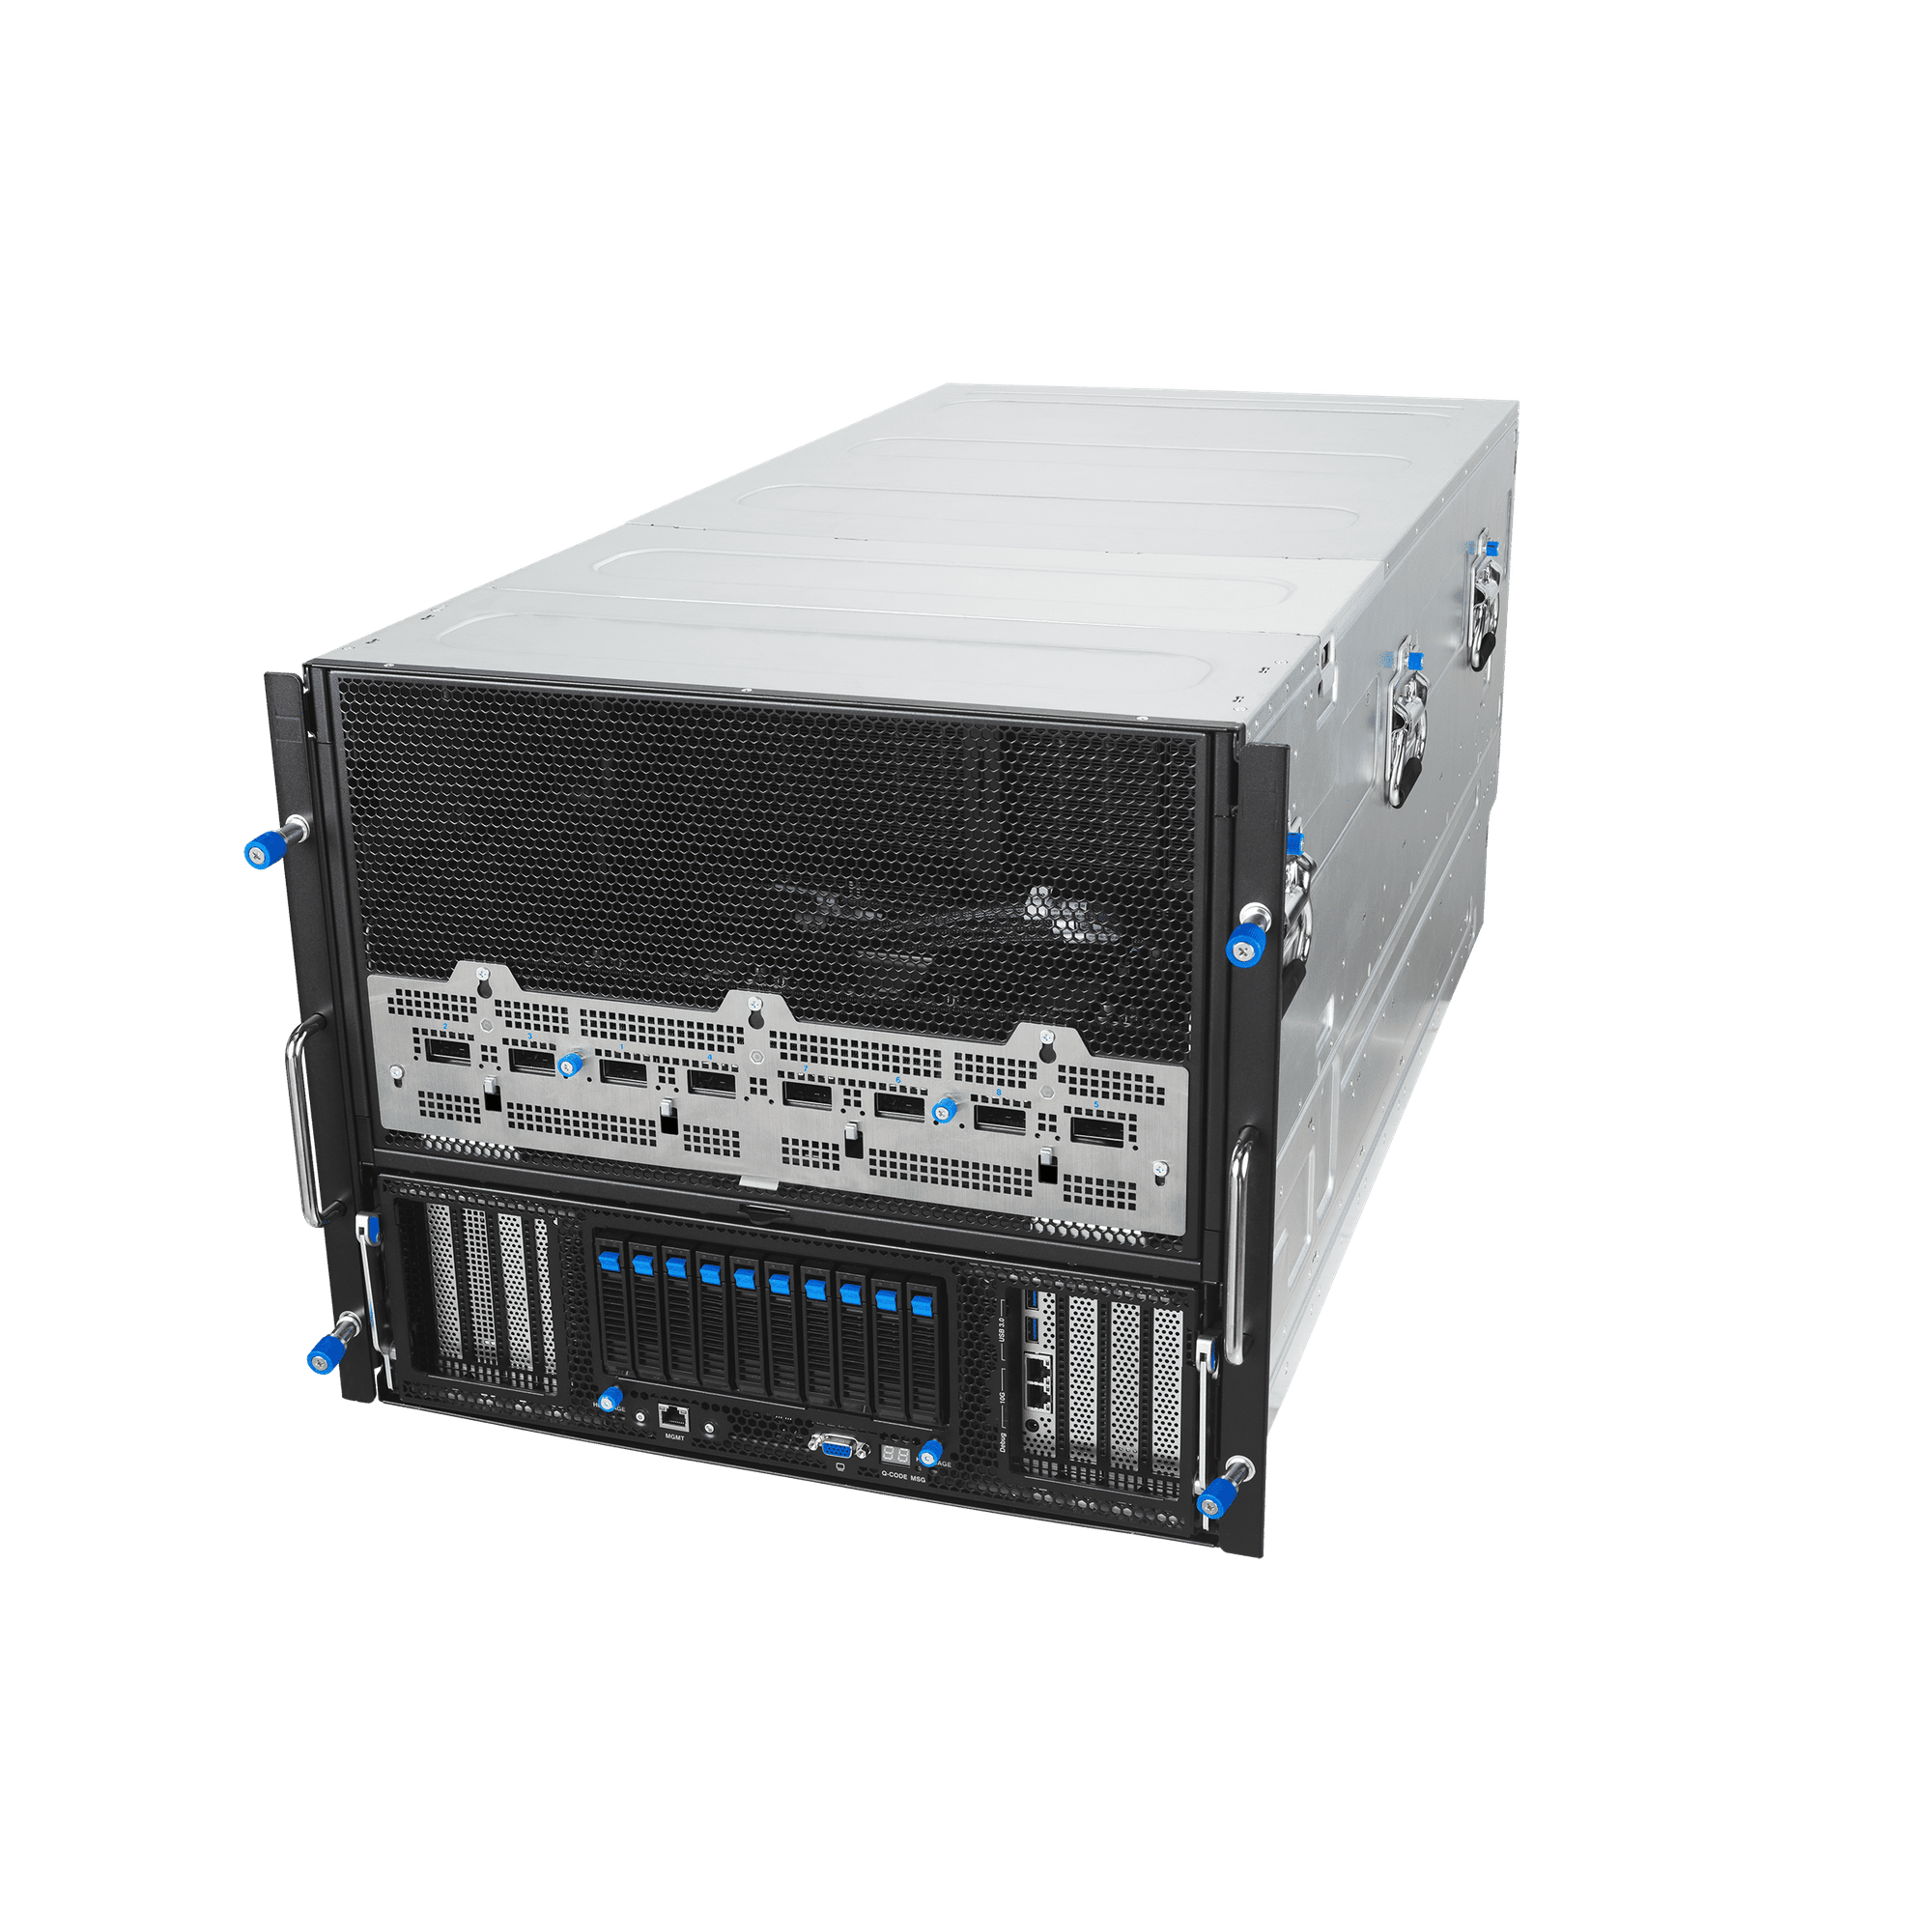
Supermicro、Dell、パートナーベンダーによるOEM HGX B300ベースボードシステム — Blackwell Ultra GPUとNVLinkファブリックが記録的なノード内帯域幅を実現。
主な仕様
適したワークロード
Rack-Scale Training
Architecture optimised for reasoning, inference, and high-throughput production clusters.
技術仕様
| Form Factor | 8U / 10U air or liquid cooled |
|---|---|
| CPU Options | Intel Xeon 6 or AMD EPYC 9005 |
| Networking | Up to 8x 400 Gb + 2x 200 Gb management |
Supermicro、Dell をはじめとする主要パートナーベンダーの OEM HGX B300 ベースボードシステムで、次世代のエンタープライズ AI インフラを構築。NVIDIA Blackwell Ultra GPU と先進の NVLink ファブリックを搭載しています。最も要求の厳しい AI およびアクセラレーテッドコンピューティングのワークロード向けに設計され、卓越した GPU 密度、高帯域幅インターコネクト、そして大規模 AI モデルのためのノード内通信性能を実現します。
NVIDIA HGX B300 プラットフォームを基盤とするこれらの AI サーバーシステムは、大規模言語モデル(LLM)のトレーニング、生成 AI、推論、ファインチューニング、科学計算、ハイパフォーマンスコンピューティング(HPC)を加速するよう設計されています。Blackwell Ultra GPU アーキテクチャと NVLink テクノロジーの組み合わせにより、ノード内の GPU 同士が極めて高い帯域幅で通信でき、通信のボトルネックを低減し、分散 AI ワークロードの効率を高めます。
次世代 AI のための NVIDIA Blackwell Ultra
NVIDIA Blackwell Ultra GPU プラットフォームは、兆パラメータ級のモデル、先進的な生成 AI、推論(リーズニング)モデル、マルチモーダルアプリケーション、高スループット推論など、ますます大規模かつ複雑化する AI ワークロードのために設計されています。
HGX B300 システムは、企業や AI インフラ事業者に対し、高い GPU 間通信性能を維持しながら計算集約型ワークロードをスケールさせるための強力な基盤を提供します。
高帯域幅 NVLink ファブリック
HGX B300 インフラの大きな利点は、高性能な NVLink GPU インターコネクトファブリックです。サーバー内の GPU 間で極めて高帯域な通信を実現することで、GPU 間のデータ交換が頻繁に発生するワークロードを高速化します。
これは特に次の用途で重要です:
LLM の事前学習および事後学習
大規模モデルのファインチューニング
生成 AI の推論
リーズニングおよびエージェント型 AI
マルチモーダル AI
Transformer ベースのワークロード
ハイパフォーマンスコンピューティング
科学シミュレーション
AI モデルサービング
GPU アクセラレーテッド分析
分散 AI アプリケーションでは、ノード内通信の高速化により GPU の稼働率を高く保ち、負荷の高い並列ワークロードにおける通信オーバーヘッドの影響を軽減できます。
主要ベンダーによる OEM HGX B300 システム
HGX B300 ベースボードシステムは、Supermicro、Dell、およびパートナーベンダーの OEM プラットフォームを通じて提供され、エンタープライズグレードの AI インフラ構築に複数の導入オプションをもたらします。
これらのシステムは、データセンター、AI クラウドプロバイダー、研究機関、そして次世代 GPU クラスターの高性能基盤を求める企業に最適です。
大規模エンタープライズ AI のための設計
AI モデルの規模と複雑さが増し続けるなか、従来型のサーバーアーキテクチャは GPU メモリ、インターコネクト帯域幅、通信オーバーヘッドによって制約を受けることがあります。Blackwell Ultra GPU と NVLink ファブリックを備えた HGX B300 システムは、大規模アクセラレーテッドコンピューティングに最適化された緊密統合の GPU アーキテクチャにより、こうした要件に応えます。
企業はこれらのプラットフォームを活用して、AI ファクトリー、LLM クラスター、生成 AI プラットフォーム、エンタープライズ推論、モデル開発、先進的な HPC アプリケーション向けのインフラを構築できます。
主なポイント
NVIDIA HGX B300 ベースボードプラットフォーム
NVIDIA Blackwell Ultra GPU
高帯域幅 NVLink GPU インターコネクト
記録的水準のノード内 GPU 通信帯域幅
Supermicro、Dell、パートナーベンダーによる OEM システム
エンタープライズ AI と HPC 向けの設計
LLM のトレーニング、推論、ファインチューニングに最適化
生成 AI、リーズニングモデル、マルチモーダルワークロードに最適
大規模 GPU クラスター向けの高性能インフラ
AI データセンター、クラウドプロバイダー、研究、企業導入に対応
Blackwell Ultra GPU、HGX B300 アーキテクチャ、NVLink ファブリックを備えたこれらのシステムは、急速に拡大するエンタープライズ AI と大規模モデルワークロードの需要を支える高性能 AI インフラを構築する組織に、次世代のプラットフォームを提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。