NVIDIA DGX
NVIDIA DGX B200
開発から展開までのパイプラインを支える統合AIプラットフォーム。Blackwell GPU 8基と1.4 TBのHBM3eを搭載し、前世代比で最大3倍のトレーニング性能と15倍の推論性能を実現。
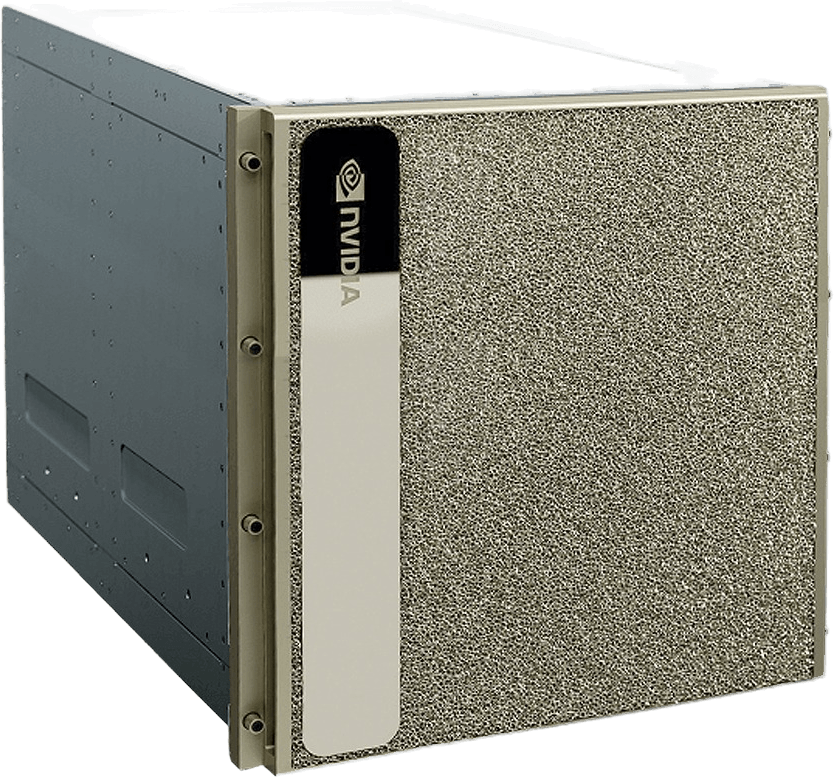
主な仕様
適したワークロード
Foundation Model Training
Full-stack platform validated for large-scale distributed training.
Multi-Modal Workloads
Vision, language, and speech pipelines on one platform.
技術仕様
| Chassis | NVIDIA DGX B200, 10U |
|---|---|
| CPU | 2x Intel Xeon Platinum 8570 |
| GPU | 8x NVIDIA B200 SXM, 1.4 TB HBM3e |
| System Memory | Up to 4 TB DDR5 |
| Networking | 8x OSFP 400 Gb InfiniBand |
NVIDIA Blackwell アーキテクチャを基盤とし、高負荷な LLM トレーニング、推論、ファインチューニング、生成 AI、ハイパフォーマンスコンピューティングのワークロード向けに設計された高性能 AI システム、NVIDIA DGX B200 で企業の人工知能を加速します。
NVIDIA DGX B200 は、複数の Blackwell GPU、高帯域幅 GPU メモリ、先進の NVLink 接続、専用設計のシステムアーキテクチャを統合した AI プラットフォームです。ますます大規模かつ高度化する AI モデルのトレーニング、ファインチューニング、デプロイに必要な演算性能と GPU 間通信を提供するよう設計されています。
大規模 AI のために構築
DGX B200 は、実験やモデルトレーニングから本番推論まで、AI 開発ライフサイクル全体をサポートするよう設計されています。高密度な GPU アーキテクチャにより、以下の用途に適しています:
大規模言語モデル (LLM) のトレーニング
LLM の推論とサービング
生成 AI アプリケーション
基盤モデルの開発
AI モデルのファインチューニング
検索拡張生成 (RAG)
AI エージェントおよび推論ワークロード
マルチモーダル AI
自然言語処理
コンピュータービジョン
機械学習
科学計算
ハイパフォーマンスコンピューティング (HPC)
NVIDIA Blackwell アーキテクチャ
NVIDIA Blackwell GPU を搭載した DGX B200 は、急速に高まる現代の AI の計算要件に対応するよう設計されています。Blackwell アーキテクチャは、大規模モデル、複雑なデータセット、計算負荷の高い生成 AI ワークロードに先進的な GPU アクセラレーションを提供します。
本プラットフォームは、緊密に統合されたマルチ GPU 環境を維持しながら、大量の GPU 演算リソースとメモリリソースを必要とする組織にとって特に価値があります。
高帯域幅 NVLink インターコネクト
DGX B200 プラットフォームの中核となるのが、高速な NVLink GPU インターコネクトです。システム内の GPU 間で迅速な通信を可能にすることで、NVLink は GPU 間のデータ交換が頻繁に発生するワークロードの高速化を支援します。
このアーキテクチャは、分散 LLM トレーニング、ファインチューニング、大規模推論において特に有効であり、通信オーバーヘッドを削減し、マルチ GPU ワークロードの効率を向上させます。
エンタープライズ AI インフラストラクチャ
NVIDIA DGX B200 システムは、企業のデータセンター、AI ファクトリー、クラウドプロバイダー、研究機関、そして大規模 AI インフラを構築する組織向けに設計されています。
統合された DGX アプローチは、AI の開発とデプロイのための即戦力となる基盤を提供し、演算、メモリ、ネットワーキング、GPU アクセラレーションを専用設計のプラットフォームに集約できます。
AI トレーニングと推論に最適
基盤モデルのトレーニングから本番 AI サービスの展開まで、DGX B200 は大量のアクセラレーターリソースを必要とする高負荷ワークロード向けに設計されています。
組織は DGX B200 インフラを活用し、生成 AI、エンタープライズ LLM、AI エージェント、レコメンデーションシステム、コンピュータービジョン、科学研究、高度な分析のためのプラットフォームを構築できます。
主なハイライト
NVIDIA DGX B200 AI システム
NVIDIA Blackwell アーキテクチャ
マルチ GPU 高性能コンピューティングプラットフォーム
高帯域幅 GPU メモリ
先進の NVLink GPU インターコネクト
LLM のトレーニングと推論向けに設計
生成 AI と基盤モデルに最適化
ファインチューニング、RAG、AI エージェント、マルチモーダルワークロードに対応
エンタープライズ AI と HPC に適合
大規模 AI インフラおよび AI ファクトリー展開向けに設計
NVIDIA Blackwell GPU、高帯域幅メモリ、NVLink 接続を組み合わせた NVIDIA DGX B200 は、次世代 AI モデルをエンタープライズ規模でトレーニング、ファインチューニング、デプロイしようとする組織に強力な基盤を提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。