NVIDIA MGX
NVIDIA MGX GB200 NVL72
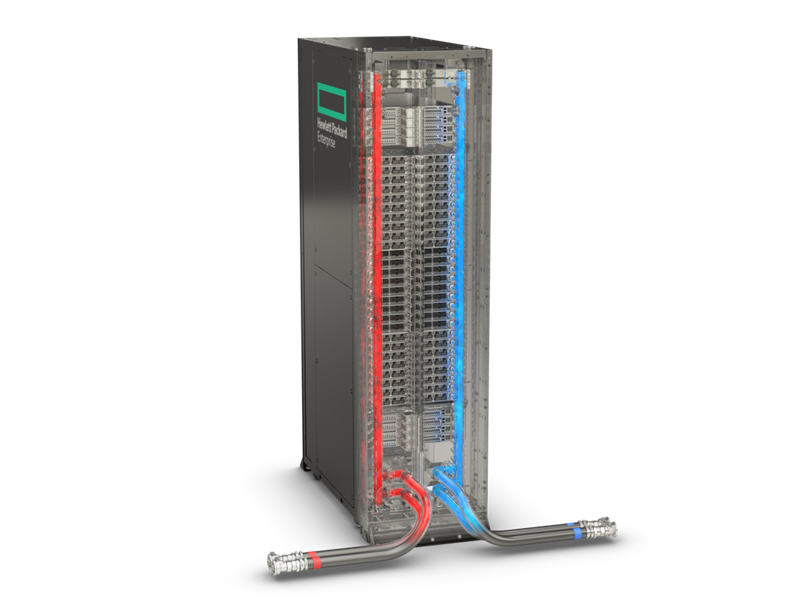
ラックスケールのAIスーパーコンピューター。72基すべてのGPUを第5世代NVLinkで相互接続し、兆パラメータ級モデルのトレーニングをシームレスにスケーリングします。
主な仕様
適したワークロード
Frontier Model Training
Train the largest foundation models at rack scale with unprecedented GPU-to-GPU bandwidth.
技術仕様
| Form Factor | Full rack, liquid cooled |
|---|---|
| Rack Power | ~120 kW |
| Interconnect | NVLink Switch System |
大規模なLLMトレーニング、推論、生成AI、推論モデル、アクセラレーテッドコンピューティング向けに設計された高密度AIコンピューティングプラットフォーム、NVIDIA MGX GB200 NVL72で次世代AIワークロードを加速します。NVIDIA Blackwellアーキテクチャと緊密に統合されたマルチGPUおよびNVLinkインフラを組み合わせたGB200 NVL72は、最も要求の厳しいAIワークロードに卓越したパフォーマンスを提供するように構築されています。
GB200 NVL72は72基のBlackwell GPUをラックスケールアーキテクチャに統合し、膨大なGPU演算性能、大容量メモリ、極めて高帯域のGPU間通信を必要とするワークロードのために強力な統合コンピュート環境を実現します。
大規模AIのために構築
NVIDIA MGX GB200 NVL72は、ますます複雑化するAIモデルやアプリケーションを運用する組織向けに設計されています。そのラックスケールアーキテクチャは、緊密に結合されたGPUリソースの恩恵を受けられる以下のようなワークロードに特に適しています。
大規模言語モデル(LLM)のトレーニング
大規模なLLM推論
生成AI
基盤モデルの開発
推論およびエージェント型AI
AIモデルのファインチューニング
マルチモーダルAI
検索拡張生成(RAG)
AIモデルのサービング
科学技術計算
ハイパフォーマンスコンピューティング(HPC)
GPUアクセラレーテッドシミュレーション
NVIDIA Blackwellアーキテクチャ
NVIDIA Blackwellプラットフォーム上に構築されたGB200 NVL72システムは、次世代のAIコンピューティングのために設計されています。本プラットフォームは、ますます大規模化するモデルと計算集約型ワークロードに対応しつつ、分散GPU処理に必要な高速通信を提供します。
そのアーキテクチャにより複数のGPUが緊密に統合されたコンピューティング環境として動作し、GPU間通信とメモリ帯域幅が全体性能を左右する大規模AIモデルにおいて特に高い価値を発揮します。
ラックスケールNVLinkアーキテクチャ
GB200 NVL72を特徴づけるのが、高帯域幅のNVLinkアーキテクチャです。GPUを個別のアクセラレータとして扱うのではなく、システム全体にわたる集中的な通信を支えるように設計された高速GPUファブリックで接続します。
このアプローチにより、大規模なモデルトレーニングや推論といった要求の厳しい分散ワークロードにおいて、通信のボトルネックを軽減しGPU利用率を向上させることができます。
スケールする企業向けAIインフラ
NVIDIA MGX GB200 NVL72は、AIファクトリー、ハイパースケールデータセンター、クラウドサービスプロバイダー、研究機関、そして次世代AIインフラを構築する企業向けに設計されています。
多数のBlackwell GPUをラックスケールシステムに統合することで、従来の単一サーバーアーキテクチャよりも大幅に大きな規模で高度なAIモデルを展開するための基盤を提供します。
主なハイライト
NVIDIA MGX GB200 NVL72プラットフォーム
72基のNVIDIA Blackwell GPU
ラックスケールAIコンピューティングアーキテクチャ
高帯域幅NVLink GPUファブリック
大規模LLMトレーニングと推論向けに設計
生成AIおよび基盤モデルに最適化
推論、エージェント型、マルチモーダルAIに対応
AIモデル開発と本番サービングに最適
ハイパースケールおよび企業向けAIインフラ向けに設計
要求の厳しいGPUアクセラレーテッドおよびHPCワークロード向けに構築
72基のGPUによるBlackwellアーキテクチャと高帯域幅NVLinkファブリックを備えたNVIDIA MGX GB200 NVL72は、次世代の大規模言語モデルと高度な生成AIアプリケーションを支える強力なAIインフラを構築したい組織に、ラックスケールの基盤を提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。