GPU Servers
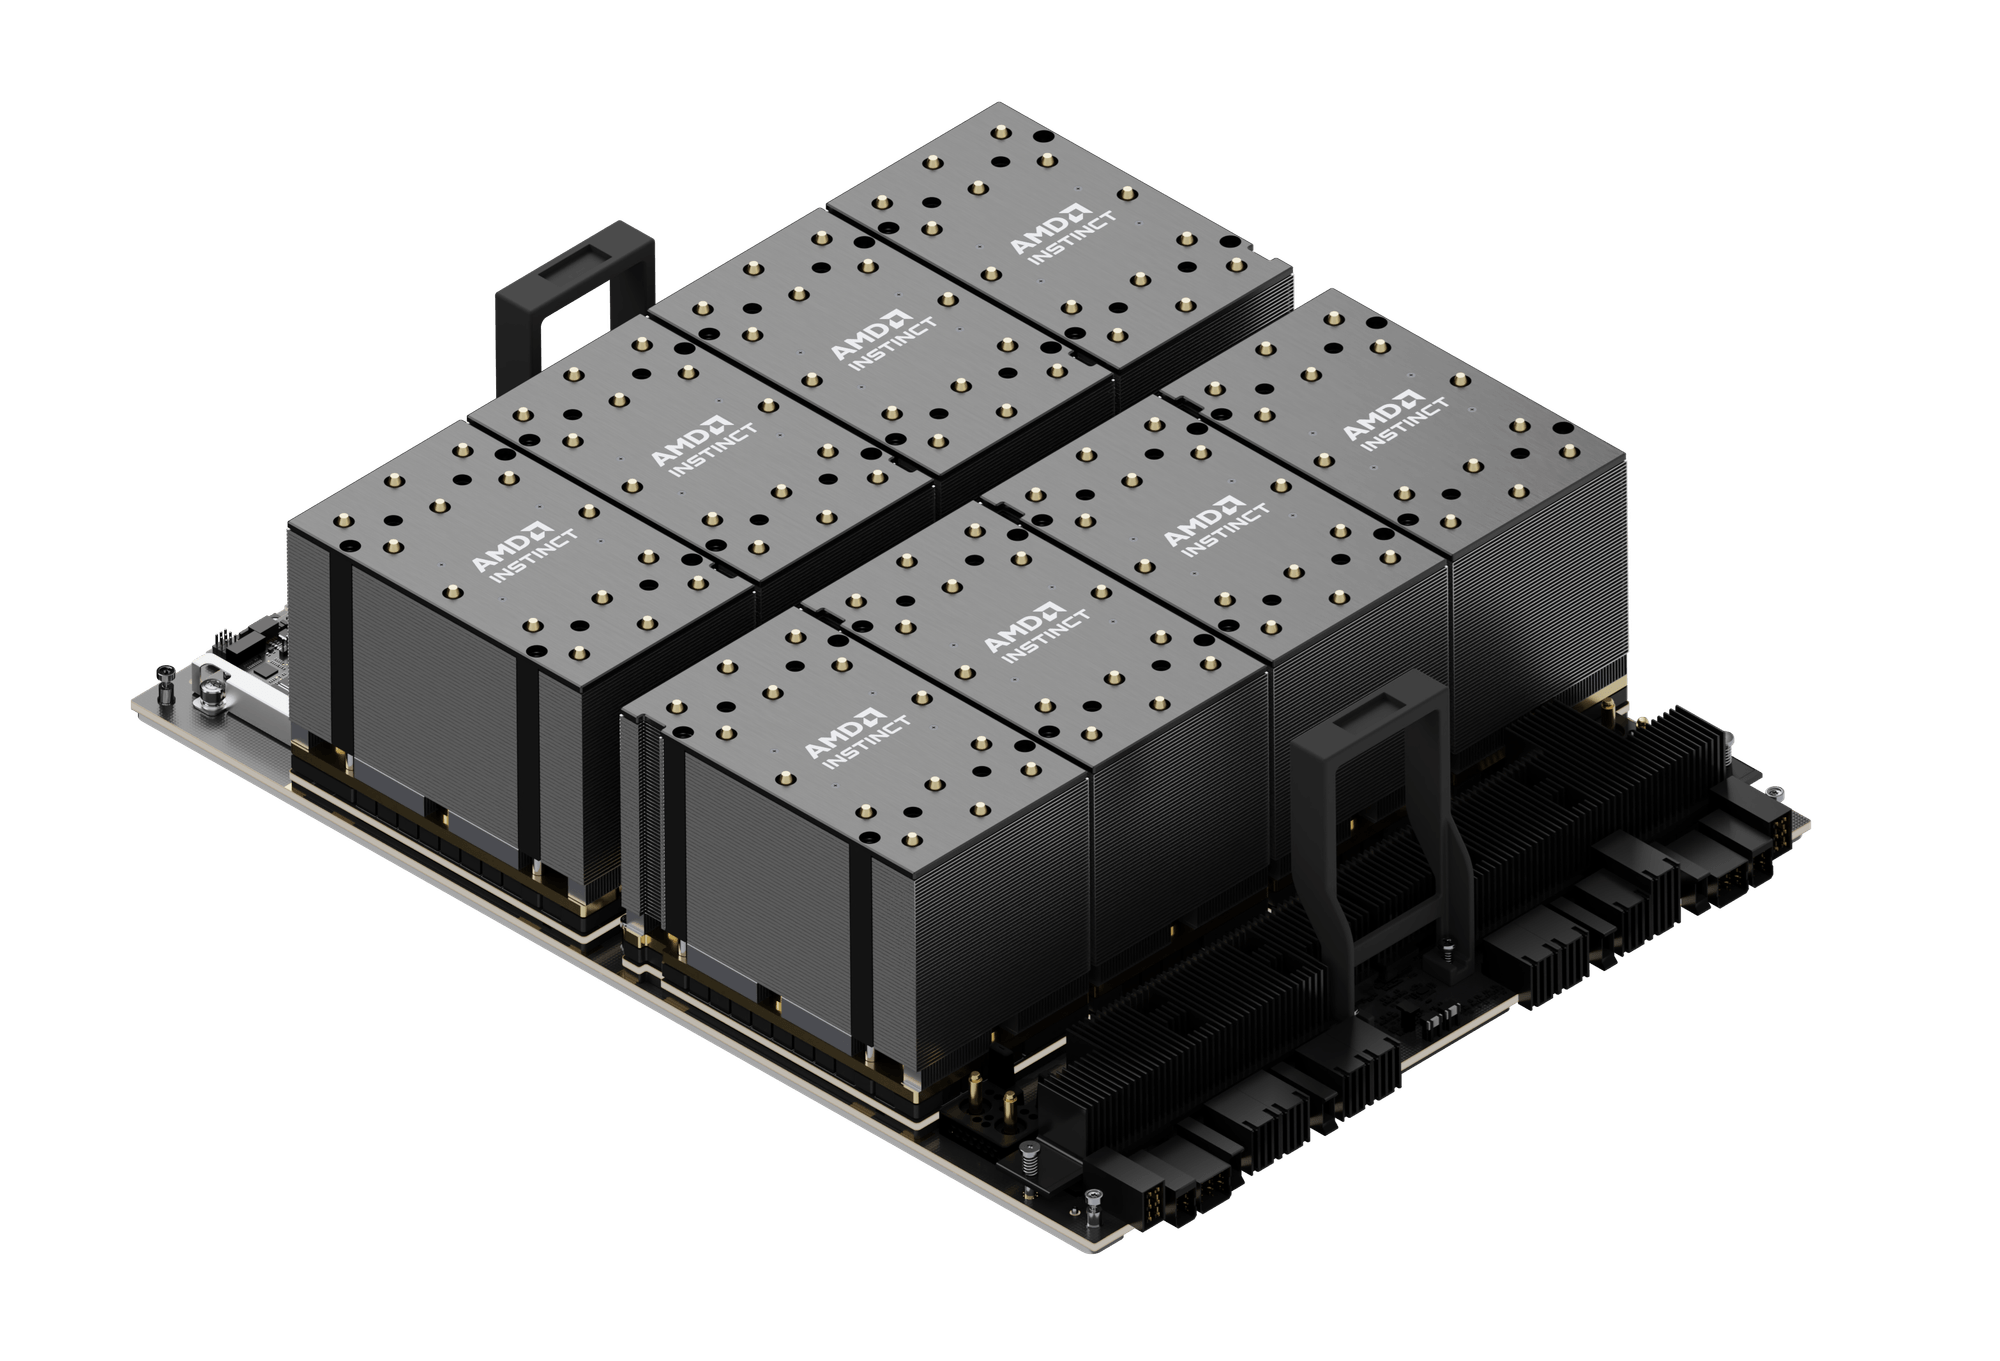
AMD Instinct MI300X サーバー
192 GB の HBM3 メモリにより、700 億パラメータ超のモデルを単一 GPU で実行可能 — 推論の複雑さとコストを削減します。
主な仕様
適したワークロード
Single-GPU 70B Inference
Run large models without tensor parallelism, simplifying the serving stack.
技術仕様
| Form Factor | 8U Rackmount |
|---|---|
| CPU | 2x AMD EPYC 9004/9005 |
AMD Instinct MI300Xサーバーで、大規模な人工知能およびハイパフォーマンスコンピューティングのワークロードを加速します。要求の厳しいLLMのトレーニング、推論、生成AI、ファインチューニング、GPUアクセラレーテッドコンピューティング向けに設計されています。AMD Instinct MI300Xアクセラレーターを中核とするこれらの高密度GPUサーバーは、ますます大規模かつ複雑化するAIモデルを運用する組織に、豊富なGPUメモリと高帯域幅の接続性を提供します。
AMD Instinct MI300Xはメモリ集約型のAIワークロードに特に適しており、MI300Xサーバーは、大規模AIコンピューティング向けの強力な選択肢を導入したい企業、AIインフラプロバイダー、研究機関、データセンターにとって魅力的なプラットフォームとなります。
大規模言語モデルと生成AIのために設計
MI300Xサーバーは、以下を含む幅広いAIワークロードをサポートするよう設計されています。
大規模言語モデル(LLM)のトレーニング
LLMの推論とサービング
生成AIアプリケーション
基盤モデルの開発
AIモデルのファインチューニング
検索拡張生成(RAG)
AIエージェントと推論ワークロード
マルチモーダルAI
自然言語処理
コンピュータービジョン
機械学習
科学技術計算
ハイパフォーマンスコンピューティング(HPC)
大容量メモリGPUアーキテクチャ
AMD Instinct MI300Xプラットフォームの主要な強みの一つは、大容量の高帯域幅GPUメモリです。これにより、モデルの重みやアクティベーションなどのデータをGPUの近くに保持することが性能上重要となる、大規模AIモデルを扱うワークロードに特に適しています。
LLM推論においては、大容量のGPUメモリによって、より大きなモデルに対応したり、より多くのアクセラレーターへモデルを分割する必要性を抑えつつ、デプロイ構成を最適化したりできます。
高性能なマルチGPUインフラ
MI300Xサーバーは複数のアクセラレーターを高密度GPUコンピューティングプラットフォームに統合でき、AIワークロードを複数のGPUに分散できます。高速なGPU間インターコネクトと最適化されたサーバーアーキテクチャが、分散モデルトレーニングや大規模推論といった通信集約型アプリケーションを支えます。
これにより、AMD Instinct MI300Xサーバーは、エンタープライズAIクラスター、プライベートAIインフラ、高性能GPUコンピューティング環境の構築に適しています。
AMD ROCmソフトウェアエコシステム
MI300Xシステムは、AMD ROCmオープンソフトウェアプラットフォームと連携するよう設計されており、GPUアクセラレーテッドなAIおよびHPCアプリケーションの開発と展開の基盤を提供します。
ROCmは拡大を続ける機械学習フレームワーク、ライブラリ、ツールのエコシステムをサポートし、既存のAI開発・インフラ環境へのAMD GPUアクセラレーションの統合を支援します。
エンタープライズAIインフラ
AMD Instinct MI300Xサーバーは、AIデータセンター、クラウドプロバイダー、企業のAI導入、研究所、HPC環境に適しています。
モデル開発、トレーニング、ファインチューニング、推論、本番AIサービスに活用でき、多大なGPU演算能力とメモリリソースを必要とするワークロードに対してスケーラブルな基盤を提供します。
主なポイント
AMD Instinct MI300X GPUサーバー
高密度マルチGPU構成
大容量・高帯域幅のGPUメモリ
LLMのトレーニングと推論向けに設計
生成AIと基盤モデルに最適
ファインチューニング、RAG、AIエージェント、マルチモーダルワークロードに対応
AIとHPC向けの高性能GPUアーキテクチャ
AMD ROCmソフトウェアエコシステムに対応
エンタープライズAIおよびデータセンター導入に適合
スケーラブルなGPUインフラのための強力なプラットフォーム
大規模言語モデル、生成AI、高スループット推論、モデルトレーニング、高度なHPCワークロードのいずれを導入する場合でも、AMD Instinct MI300Xサーバーは現代のAIインフラに大容量メモリと高性能の基盤を提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。