AI Servers
AIサーバー GPU 1基
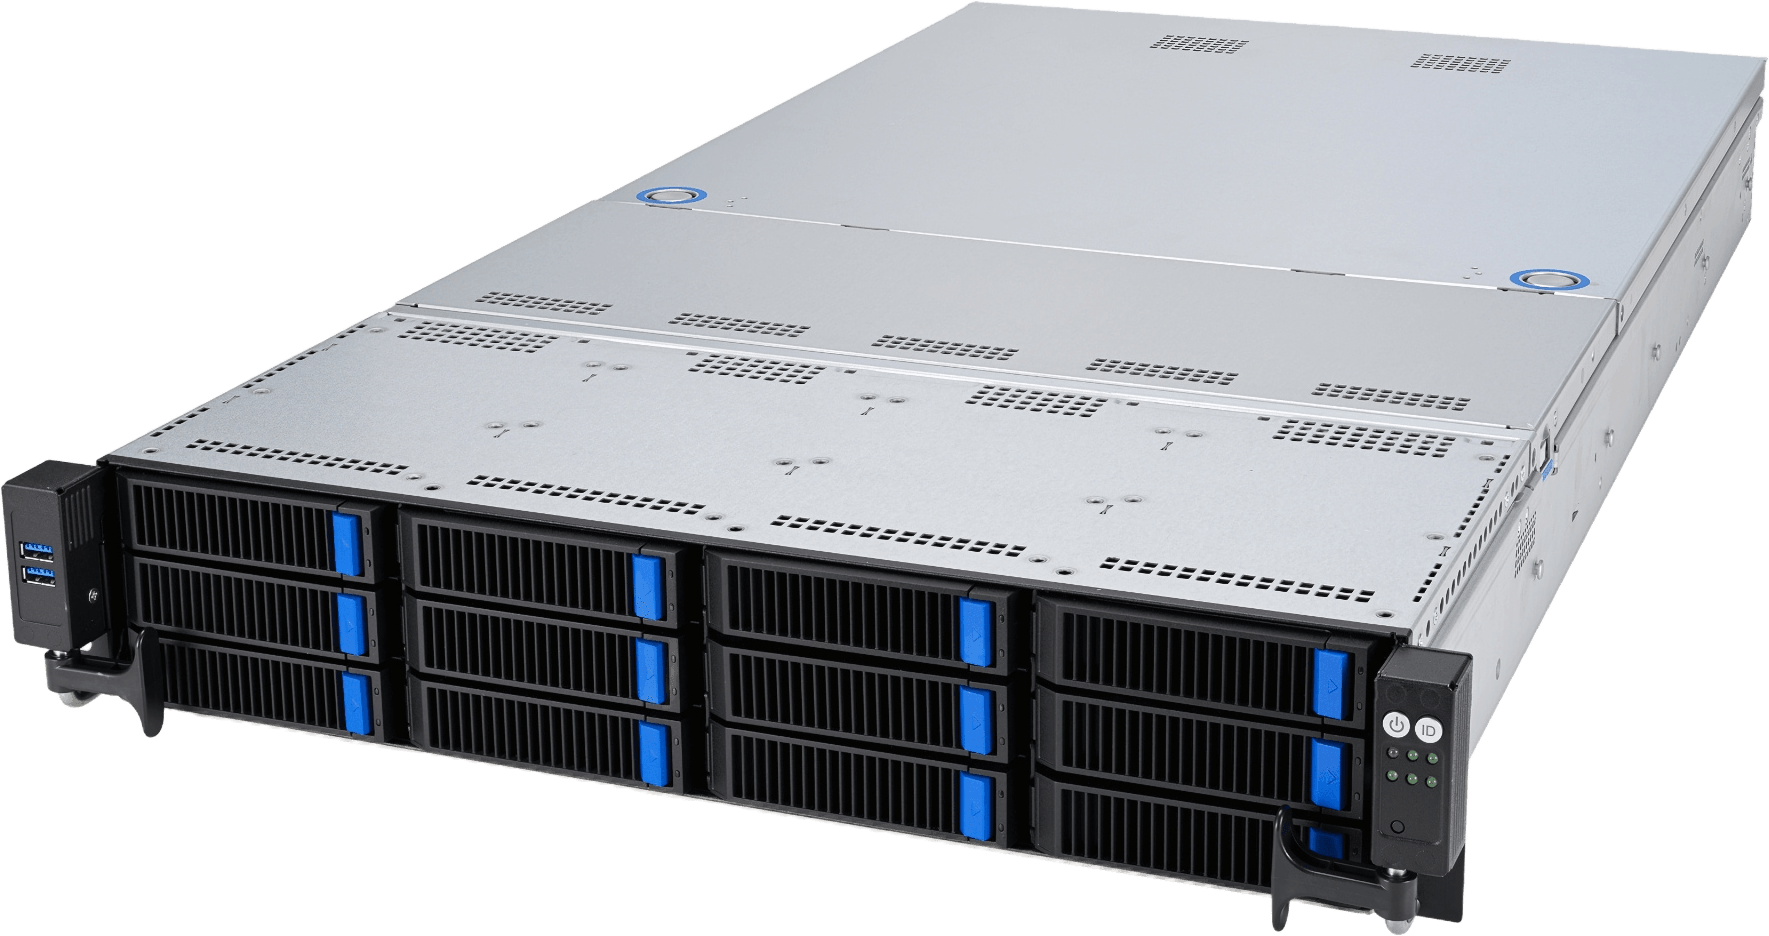
AMD EPYC上にNVIDIA L4、L40S、H100 NVLのいずれか1基を搭載したエントリーレベルのAIサーバー — 開発、推論のパイロット、部門単位のワークロードに最適。
主な仕様
適したワークロード
Inference Pilots
Prove the use case before committing to cluster-scale capex.
Development Nodes
Give data science teams dedicated, predictable compute.
技術仕様
| Chassis | 2U Rackmount |
|---|---|
| Memory | 128 GB – 768 GB DDR5 |
| Storage | 2x 1.92 TB NVMe (expandable) |
機械学習、生成AI、LLM推論、モデル開発、GPUアクセラレーテッドワークロード向けに設計された1 GPU AIサーバーで、効率的かつスケーラブルなAIインフラを構築できます。シングルGPUサーバーは、マルチGPUシステムのような複雑さやコストをかけずに、企業・研究・開発環境に専用GPU演算基盤を追加するコスト効率の高い手段です。
シングルGPU AIサーバーは、コンパクトで柔軟なインフラ規模を維持しながら、AIアプリケーション向けに専用アクセラレーター性能を必要とする組織にとって理想的なソリューションです。これらのシステムは、ワークロード要件、性能目標、メモリ容量、導入環境に応じて、さまざまな最新データセンター向けGPUで構成できます。
AIおよびGPUアクセラレーテッドワークロード向けに構築
1 GPUサーバーは、以下を含む幅広いアプリケーションに対応します。
LLM推論とサービング
生成AIアプリケーション
機械学習トレーニング
AIモデルのファインチューニング
コンピュータービジョン
自然言語処理
RAGおよびAIアプリケーション
AIの開発とテスト
GPUアクセラレーテッド分析
科学技術計算
映像・画像処理
エンタープライズAIワークロード
コスト効率に優れたAIインフラ
複数のGPUを必要としないワークロードでは、1 GPU AIサーバーが大規模GPUシステムの効率的な代替手段となります。まずはシングルアクセラレーターから始め、ワークロードや性能要件の拡大に合わせてインフラを拡張できます。
このアプローチは、過剰なインフラ投資を避けつつ専用GPU演算資源を求めるAIスタートアップ、企業の開発チーム、研究所、大学、プライベートクラウド環境、エッジAI導入において特に有効です。
柔軟なシングルGPU構成
用途に応じて、1 GPU AIサーバーには、演算性能、GPUメモリ、電力効率、ワークロードアクセラレーションのさまざまな組み合わせに最適化されたプロフェッショナル向けまたはデータセンター向けGPUを搭載できます。
本プラットフォームは開発環境と本番環境の双方で利用でき、AIインフラを段階的に導入する組織にとって汎用性の高い構成要素となります。
主な特長
1 GPU AIサーバー構成
AIワークロード向けの専用GPUアクセラレーション
LLM推論と機械学習向けに設計
生成AIおよびモデル開発に最適
AIファインチューニングとGPUアクセラレーテッドアプリケーションに対応
コンパクトで効率的なインフラ規模
マルチGPUサーバーに代わるコスト効率の高い選択肢
柔軟なGPU構成オプション
企業、研究、開発、プライベートAI環境に最適
将来のGPUインフラ拡張に向けたスケーラブルな基盤
1 GPU AIサーバーは、エンタープライズGPUコンピューティングへの実用的な入り口として、AIおよび機械学習ワークロードに専用のアクセラレーションを提供しつつ、計算要件の増加に応じて拡張できる柔軟性を備えています。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。