AI Servers
AIサーバー 4 GPU
コンパクトな2Uシャーシに最大4基のNVIDIA GPUを搭載。ラックユニットあたりのGPU密度を最大化し、中規模のAIトレーニングと同時推論に対応。
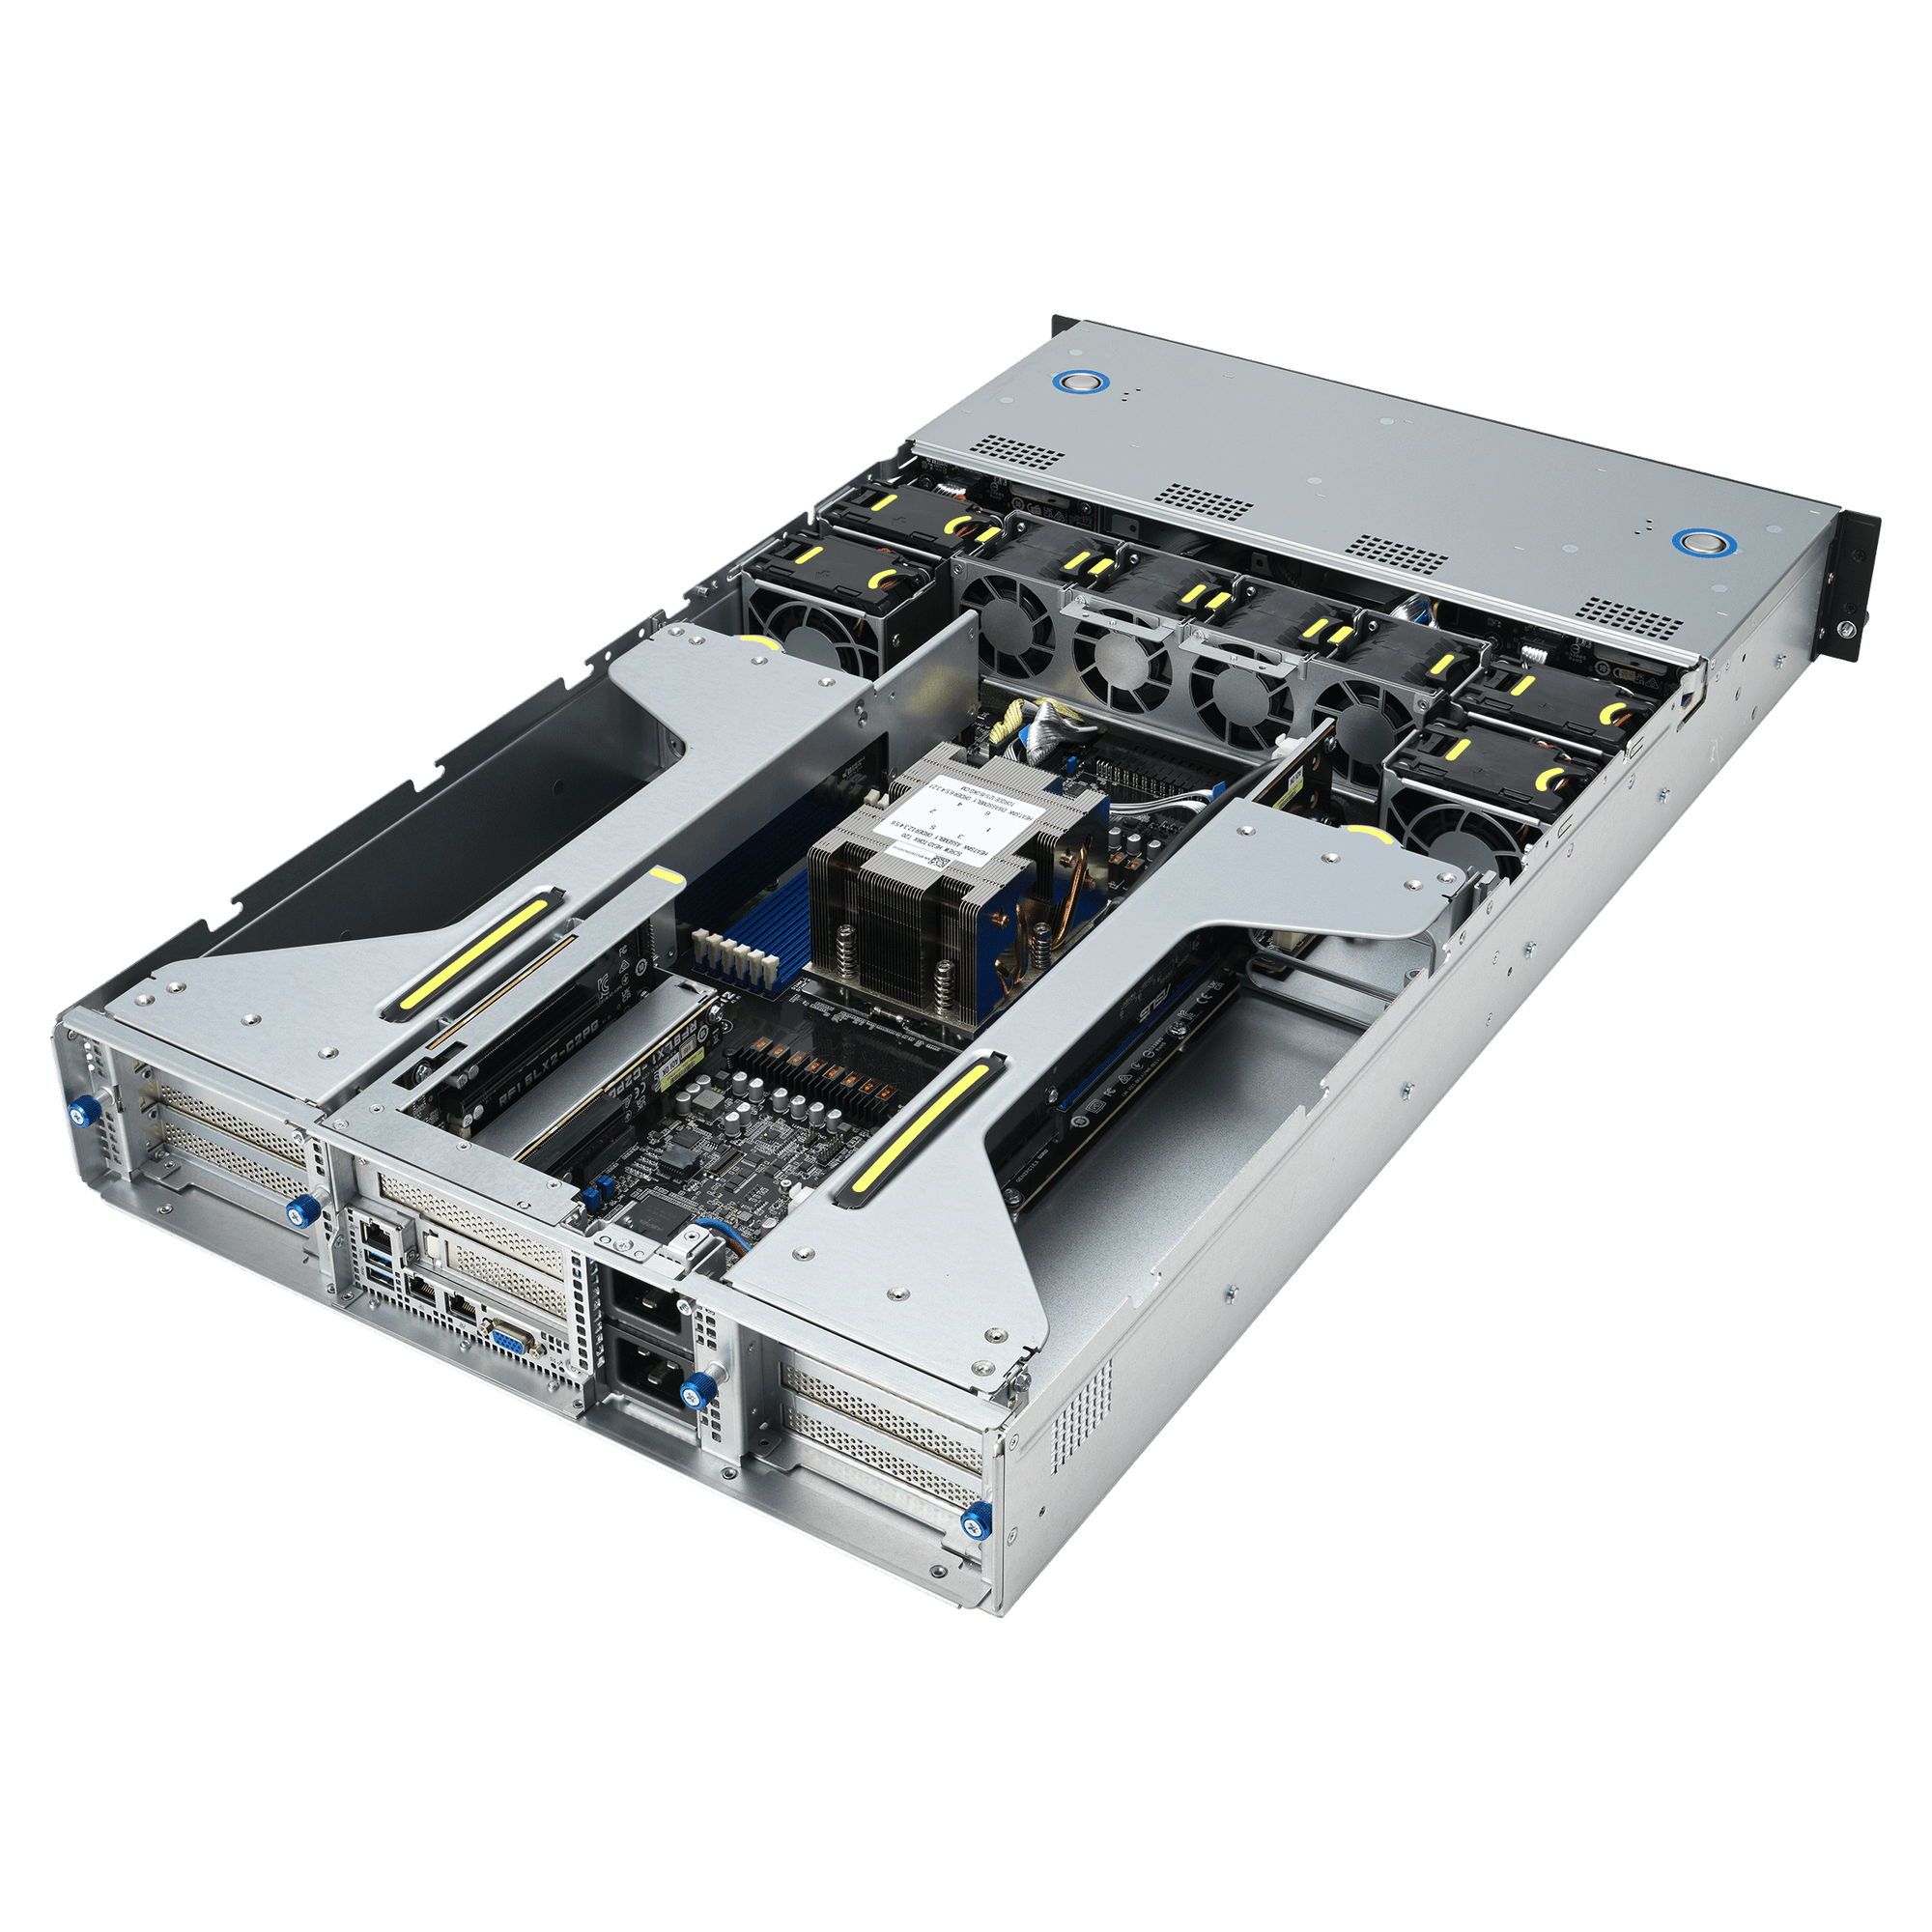
主な仕様
適したワークロード
Mid-Scale Training
Train models efficiently with up to 4x NVIDIA H100 NVL GPUs.
Concurrent Inference
Run multiple isolated inference workloads on one node.
技術仕様
| Chassis | 2U Rackmount |
|---|---|
| GPU Support | L4, L40S, H100 NVL — 2 to 4 GPUs |
| Memory | Up to 1.5 TB DDR5 |
高性能なLLMの学習、推論、ファインチューニング、生成AI、GPUアクセラレーテッドコンピューティング向けに設計された4 GPU AIサーバーで、要求の厳しい人工知能・機械学習ワークロードを高速化します。高性能GPU 4基を1台のサーバーに統合することで、企業、AI開発者、研究機関、データセンターに対し、計算密度、拡張性、インフラ効率の優れたバランスを提供します。
4 GPU AIサーバーは、シングルGPUやデュアルGPUのシステムを大きく上回るGPU演算性能とメモリを必要としながらも、大規模なマルチノードGPUクラスターよりコンパクトかつコスト効率に優れた構成を求めるワークロードに最適なソリューションです。この構成はAI開発環境と本番環境の双方に適しています。
エンタープライズAIと機械学習のために構築
4基のGPUが連携することで、以下を含む幅広い計算集約型アプリケーションを高速化できます:
大規模言語モデル(LLM)の学習
LLM推論とモデルサービング
生成AIアプリケーション
AIモデルのファインチューニング
基盤モデルの開発
検索拡張生成(RAG)
AIエージェントと推論ワークロード
コンピュータービジョン
自然言語処理
マルチモーダルAI
GPUアクセラレーテッド分析
科学技術計算とHPC
AI研究と実験
高密度マルチGPUアーキテクチャ
4 GPUサーバーは、複数のアクセラレーターにワークロードを分散できるアプリケーション向けに、緊密に統合されたマルチGPU環境を提供します。選択するGPUとサーバープラットフォームによっては、高速なGPUインターコネクト技術によりGPU間の通信が向上し、頻繁なデータ交換を必要とするワークロードを高速化できます。
これにより、4 GPUシステムは、追加のGPUリソースが処理時間を大幅に短縮できるAI学習、分散推論、シミュレーション、その他の並列ワークロードにとって特に魅力的な選択肢となります。
柔軟なAIインフラ
4 GPU AIサーバーは、ワークロード要件、GPUメモリのニーズ、電力制約、性能目標に応じて、NVIDIAをはじめとする各種クラスのアクセラレーターハードウェアで構成できます。この柔軟性により、画一的な構成を採用するのではなく、特定のAIアプリケーションに合わせたインフラを構築できます。
エンタープライズデータセンター、AIスタートアップ、研究所、大学、プライベートAIクラウド、GPUコンピューティング環境に適しています。
主なポイント
4 GPU AIサーバー構成
高性能マルチGPUアーキテクチャ
LLMの学習と推論向けに設計
生成AIと基盤モデルに最適
ファインチューニング、RAG、AIエージェント、マルチモーダルワークロードに対応
1台のサーバーで高いGPU演算密度
AI開発、研究、本番運用に適合
柔軟なGPUおよびサーバー構成
スケーラブルなAIインフラの効率的な基盤
大規模GPUクラスターへの理想的なステップ
大規模言語モデルの開発、生成AIアプリケーションの展開、基盤モデルのファインチューニング、GPU集約型の研究ワークロードの実行など、いずれの用途でも、4 GPU AIサーバーは最新のAIインフラを加速するために必要な計算密度と拡張性を提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。