NVIDIA DGX
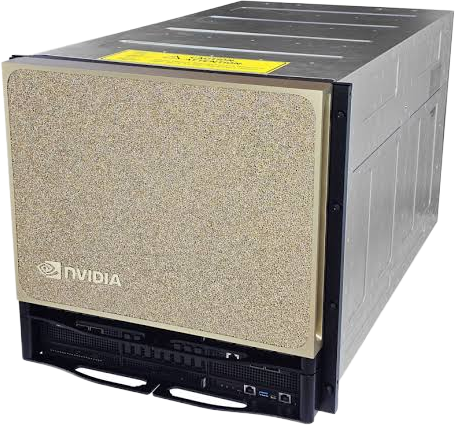
NVIDIA DGX B300
NVIDIA B300 SXM GPUを8基、2.1 TBのHBM3e GPUメモリ、合計64 TB/sのGPUメモリ帯域幅を備えた高性能エンタープライズAIスーパーコンピュータ。UAEおよびMENA地域全域で納入・導入を実施。
主な仕様
適したワークロード
LLM Training & Fine-Tuning
Train and fine-tune trillion-parameter models at unprecedented speed on managed infrastructure.
Enterprise AI Inference
Deploy production inference at scale with the lowest cost per token.
Agentic AI Pipelines
Run complex reasoning and multi-agent orchestration workloads with guaranteed uptime.
技術仕様
| Chassis | NVIDIA DGX B300, 10U |
|---|---|
| CPU | 2x Intel Xeon 6776P (64-core, 2.3 GHz) |
| GPU | 8x NVIDIA B300 SXM |
| NVSwitches | 6x NVIDIA NVSwitch |
| Storage (Data) | 30 TB NVMe SSD |
| Storage (OS) | 2x 1.92 TB NVMe |
| Networking | 8x 400 Gb InfiniBand / Ethernet |
NVIDIA Blackwell Ultraプラットフォームを基盤とする高性能AIシステム、NVIDIA DGX B300で次世代のエンタープライズAIを加速。要求の厳しいLLMのトレーニング、推論、ファインチューニング、生成AI、推論(リーズニング)モデル、AIファクトリーのワークロード向けに設計されたDGX B300は、先進的なAIを大規模に開発・展開する組織に強力な基盤を提供します。
NVIDIA DGX B300は、複数のBlackwell Ultra GPU、高帯域幅のGPUメモリ、先進的なNVLink接続、最適化されたシステムアーキテクチャを、統合されたAIコンピューティングプラットフォームとして結集します。この緊密に結合された設計は、ますます大規模かつ複雑化するAIモデルが求める演算性能とGPU間通信を実現するよう設計されています。
高度なLLMワークロード向けに構築
DGX B300は、モデル開発・トレーニングから本番推論まで、AIライフサイクル全体をサポートするよう設計されています。高密度なGPUアーキテクチャにより、以下のようなワークロードに適しています。
大規模言語モデル(LLM)のトレーニング
LLMの推論とサービング
生成AI
基盤モデルの開発
AIモデルのファインチューニング
リーズニングおよびエージェント型AI
検索拡張生成(RAG)
マルチモーダルAI
自然言語処理
コンピュータービジョン
AI研究および実験
ハイパフォーマンスコンピューティング(HPC)
NVIDIA Blackwell Ultraアーキテクチャ
NVIDIA Blackwell Ultra GPUを中核とするDGX B300は、急速に拡大する現代AIの演算要件に対応するよう設計されています。本プラットフォームは、大規模データセットと高度化するAIモデルの処理に必要な性能、メモリ帯域幅、インターコネクト機能を提供します。
そのアーキテクチャは、高いGPU利用率とアクセラレータ間の高速通信が全体性能に不可欠なワークロードに特に適しています。
高帯域幅のNVLink接続
DGX B300アーキテクチャの重要な構成要素が、高速なNVLink GPUインターコネクトです。GPU間の高帯域幅通信を可能にすることで、NVLinkは緊密に結合されたマルチGPUワークロードを支え、要求の厳しいAI処理における通信オーバーヘッドを低減します。
これは、モデルやワークロードが複数のGPUに分散される大規模トレーニング、ファインチューニング、推論において特に有用です。
エンタープライズAIとAIファクトリー基盤
NVIDIA DGX B300は、エンタープライズAI基盤、AIファクトリー、プライベートAIクラウド、研究環境、大規模GPUクラスターを構築する組織向けに設計されています。
AIワークロードがより大きなモデル、より多い推論量、より高度な推論能力へと向かうなか、DGX B300は導入を加速し、先進的なAIコンピューティングに必要な基盤を簡素化する統合プラットフォームを提供します。
主なポイント
NVIDIA DGX B300 AIシステム
NVIDIA Blackwell Ultra GPUアーキテクチャ
高密度マルチGPU構成
高帯域幅GPUメモリ
先進的なNVLink GPUインターコネクト
LLMのトレーニングと推論向けに設計
生成AIおよび基盤モデルに最適化
リーズニング、エージェント型、マルチモーダルAIに対応
エンタープライズAIおよびAIファクトリー導入に最適
要求の厳しいアクセラレーテッドコンピューティングとHPCワークロード向けに構築
Blackwell Ultra GPU、高帯域幅メモリ、先進的なNVLink接続の組み合わせにより、NVIDIA DGX B300は次世代の大規模AIモデルをトレーニング、ファインチューニング、展開しようとする組織に強力なエンタープライズAIプラットフォームを提供します。
よくあるご質問
Do you provide GPU servers for AI model training and inference?
What lead times should I expect for GPU servers?
Do you offer financing for GPU infrastructure?
How can I request a consultation or quotation?
始める準備はできましたか?
AIインフラを構築する 確かな自信とともに
当社のエンタープライズインフラチームにご相談ください。専門的なアドバイス、GPUの価格、カスタム導入プランをご提供します——お約束は不要です。